올라마(Ollama) 사용법, 맥 설치부터 코덱스 연결까지 직접 해 보니
맥에서 ollama를 설치하고 첫 모델을 돌리는 순서를 정리했습니다. 이어서 코덱스에 같은 버그 수정을 클라우드 모델과 올라마의 로컬 gpt-oss:20b로 3번씩 맡겨 성공 횟수, 걸린 시간, 끊긴 오류를 비교했습니다.
Finn ·
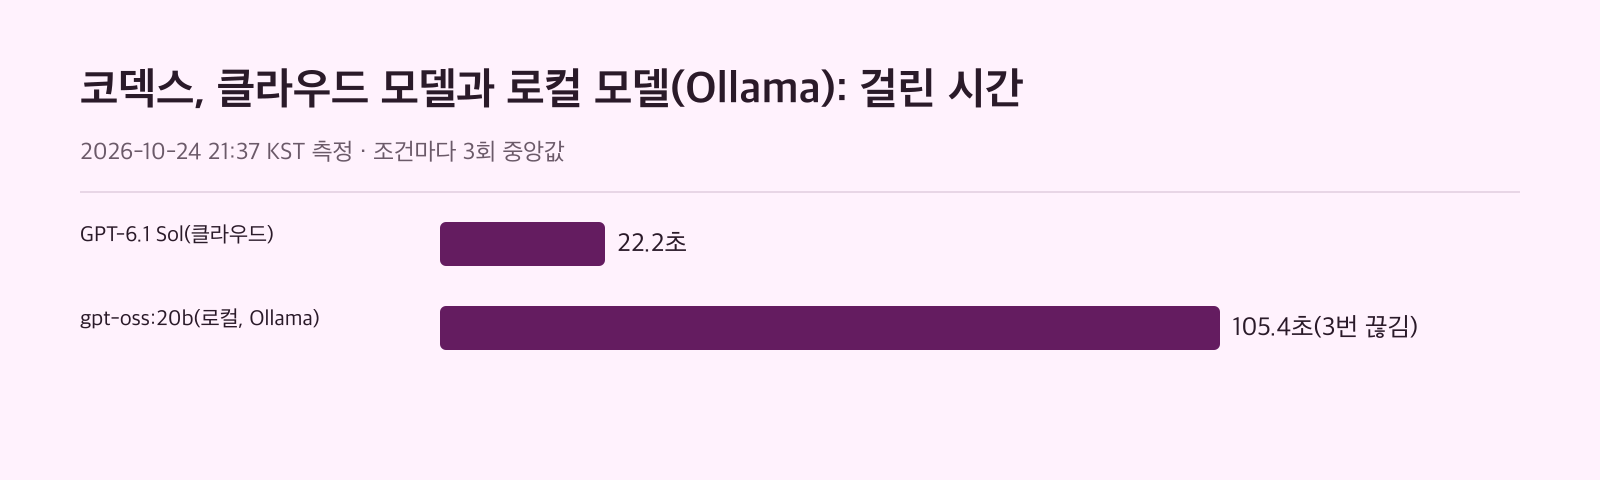
Apple M5 Max 맥에서 올라마(Ollama)로 gpt-oss:20b를 돌리면 답을 초당 91.0~92.2토큰 속도로 만듭니다. 그런데 같은 모델을 코덱스(Codex) CLI에 붙여 장바구니 금액 계산 버그를 3번 맡겼더니, 3번 모두 작업이 끝나기 전에 연결이 끊겼습니다. 같은 요청을 받은 클라우드 모델 GPT-6.1 Sol은 3번 모두 테스트를 통과시켰고, 중앙값으로 22.2초가 걸렸죠. 맥에서는 Ollama 앱을 먼저 설치한 뒤 ollama로 초기 설정을 진행합니다.
맥에 설치하고 첫 모델 돌리는 순서
설치는 macOS 문서와 퀵스타트에 나온 순서를 그대로 따르면 됩니다. macOS Sonoma(v14) 이상이 필요합니다. Apple M 시리즈 맥은 CPU와 GPU를 쓰고, x86 맥은 CPU만 써요.
- 앱 설치: 공식 문서가 권하는 방법은
ollama.dmg를 마운트한 뒤 Ollama 앱을Applications폴더로 끌어 놓는 것입니다. 앱을 처음 켜면 PATH에ollamaCLI가 있는지 확인하고, 없으면/usr/local/bin에 링크를 만들어도 되는지 묻습니다. 터미널로 설치하고 싶다면 GitHub 저장소의 README에 있는 설치 스크립트를 써도 됩니다.
curl -fsSL https://ollama.com/install.sh | sh- 첫 실행: 터미널에서 아래 명령을 실행하고 안내를 따르세요. 클라우드 모델을 쓰려면 로그인하고, 아니면 로컬 모델을 고르면 됩니다.
ollama- 모델 받기: 퀵스타트 예시 모델은 Gemma 4 E2B입니다. 내려받는 크기는 약 7.2 GB이고, 공식 문서는 쓸 수 있는 VRAM(맥이라면 통합 메모리)을 8 GB 확보하라고 권합니다. 컨텍스트 창을 크게 잡을수록 메모리도 더 필요하죠. 이 글의 측정에 쓴 모델을 받으려면 같은 명령의 모델 이름 자리에
gpt-oss:20b를 넣으면 됩니다.
ollama pull gemma4:e2b- 대화해 보기: 아래 명령을 실행하면 내 컴퓨터에서 대화가 시작됩니다. 끝낼 때는
/bye를 입력하세요.
ollama run gemma4:e2b- 로컬 API 호출: 로컬 서버 주소는
http://localhost:11434이고, 로컬 모델에는 API 키가 필요 없습니다.
curl http://localhost:11434/api/chat \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemma4:e2b",
    "messages": [
      {
        "role": "user",
        "content": "Say hello in one sentence."
      }
    ],
    "stream": false
  }'
모델과 설정은 ~/.ollama에, 서버 로그는 ~/.ollama/logs/server.log에 쌓입니다. 공식 문서는 모델 하나가 수십에서 수백 GB까지 될 수 있다고 안내하니, 디스크 여유 공간부터 확인해 보세요. 참고로 ollama/ollama 저장소의 GitHub 별은 2026-10-24 21:45 KST 기준 184,597개입니다.
함께 읽을 글
이 맥에서 잰 로컬 모델 속도
설치가 끝났다면 궁금한 건 하나겠죠. 내 맥에서 얼마나 빠를까요? 이 측정은 Ollama API(/api/generate, 스트리밍 끔)에 "자바스크립트로 배열의 숫자를 모두 더하는 함수를 짧게 써 주세요."라는 같은 질문을 3번 보냈습니다.
| 항목 | 측정값 |
|---|---|
| 측정한 컴퓨터 | Apple M5 Max, 메모리 36GB |
| Ollama 버전 | 0.40.8 |
| 모델 | gpt-oss:20b (파라미터 20.9B) |
| 양자화 | MXFP4 |
| 내려받은 크기 | 13.8GB |
| 답 생성 속도(1~3회) | 92.2 / 91.7 / 91.0 토큰/초 |
| 답 토큰(1~3회) | 249 / 250 / 404 |
| 전체 시간(1~3회) | 7.6 / 2.8 / 4.5초 |
1회차에만 모델 불러오기 시간 4.8초가 들어 있습니다. 서버를 막 띄운 직후의 첫 요청에서 잰 값이고, 2·3회차의 불러오기 시간은 0.0초였어요. 속도 역시 이 컴퓨터에서 잰 값이라 메모리가 다른 맥에서는 달라질 수 있습니다.
코덱스에 버그 수정을 맡긴 결과는?
그렇다면 이 속도로 코딩 에이전트까지 돌릴 수 있을까요? 측정은 장바구니 금액 계산 파일 src/cart.js를 고치는 작업 하나를 코덱스 CLI에 맡겼습니다. 요청은 "test/cart.test.js의 테스트가 모두 통과하도록 src/cart.js를 고쳐 주세요. 테스트 파일은 고치지 마세요. 고친 뒤 node --test로 확인해 주세요."였습니다. 테스트는 정률 쿠폰의 원 단위 아래 버림, 정액 쿠폰이 0원 아래로 내려가지 않기, 5만 원부터 배송비 무료, 할인 뒤 금액으로 배송비 정하기 같은 조건을 확인해요.
조건마다 작업 폴더를 새로 복사해 3번씩 번갈아 실행했고, 실행 뒤 node --test가 통과하면서 테스트 파일이 그대로일 때만 성공으로 셌습니다.
| 조건 | 성공 | 걸린 시간(중앙값) | 입력 토큰 | 캐시 읽기 | 출력 토큰 | 추론 토큰 | 도구 호출 |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Sol(클라우드) | 3/3 | 22.2초 | 58,731 | 51,840 | 501 | 0 | 4 |
| gpt-oss:20b(로컬, Ollama) | 0/3 | 105.4초 | 기록 없음 | 기록 없음 | 기록 없음 | 기록 없음 | 4 |
회차별로 보면 클라우드 모델은 23.5초, 22.2초, 21.7초에 모두 성공했습니다. 로컬 모델은 91.6초, 105.4초, 160.1초 만에 3번 모두 실패했고, 도구 호출은 각각 4번, 3번, 4번이었어요. 로컬 모델이 끊긴 3회는 모두 코덱스가 아래 오류로 턴을 끝냈습니다.
stream disconnected before completion: stream closed before response.completed그래서 로컬 쪽은 토큰 기록이 남지 않았습니다. 걸린 시간은 클라우드의 4.7배로 계산되지만, 로컬 쪽은 작업을 마친 시간이 아니라 끊길 때까지 걸린 시간이라는 점을 감안해서 읽어야 합니다.
로컬 모델을 코덱스에 연결하는 방법
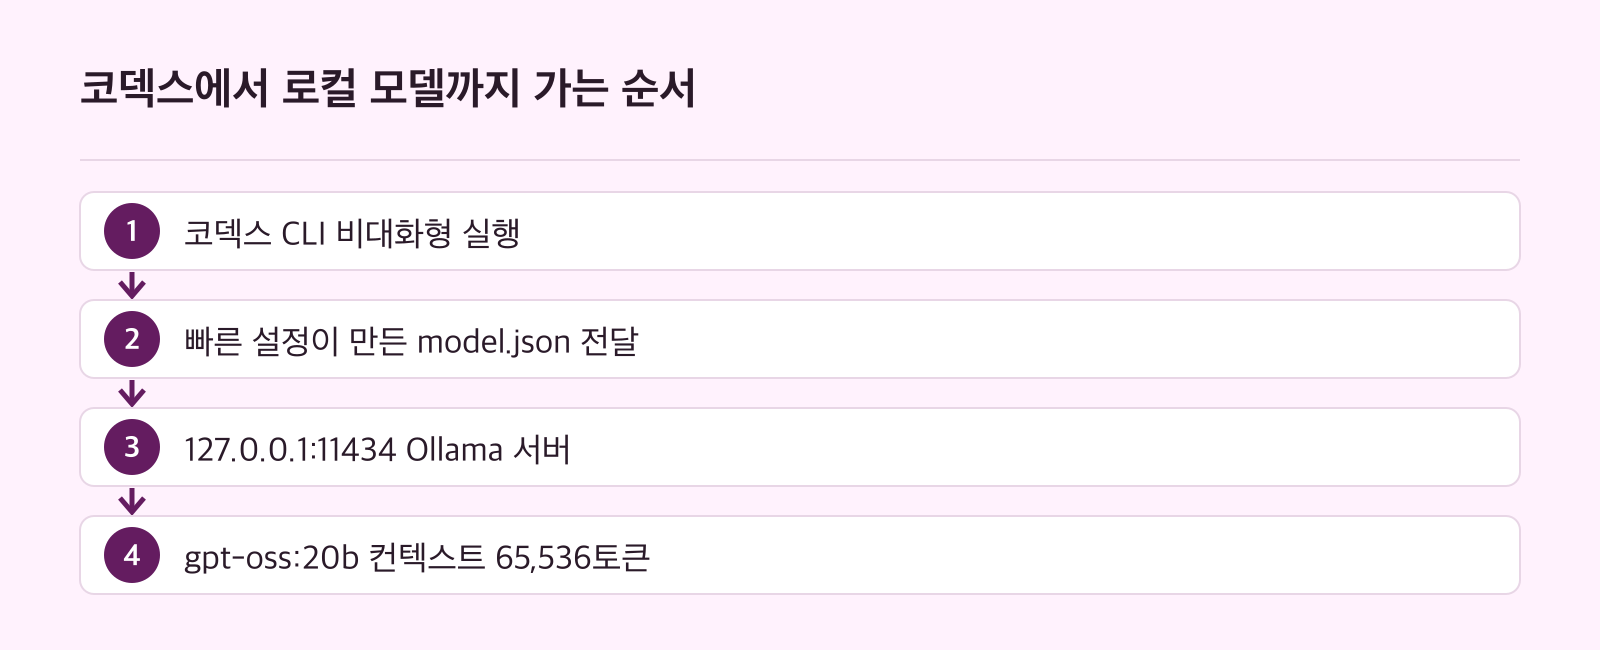
그럼 연결을 잘못해서 끊긴 걸까요? 이 측정은 Ollama의 Codex CLI 문서가 안내하는 빠른 설정이 만드는 모델 정보를 그대로 썼습니다. 직접 따라 해 보려면 아래 순서로 진행하세요.
- 코덱스 CLI를 설치합니다.
npm install -g @openai/codex- Ollama 서버를 띄웁니다. 아래는 이 측정에서 쓴 명령으로, 컨텍스트 길이를 65,536토큰으로 정합니다. 접속 주소는
127.0.0.1:11434였고, 서버를 네트워크에 여는 설정은 하지 않았습니다.
OLLAMA_CONTEXT_LENGTH=65536 ollama serve- 프로젝트 폴더에서 빠른 설정으로 코덱스를 엽니다. 이렇게 열면 Ollama가 모델 목록을 새로 고치고, 그 세션에만 쓰는 코덱스 전용 프로필을 씁니다.
ollama launch codex- 코덱스 안에서
/model을 입력하면 다시 켜지 않고도 설치된 모델 가운데 도구를 쓸 수 있는 Ollama 모델로 바꿀 수 있습니다. 목록에 넣고 싶은 모델은 실행 전에ollama pull <model>로 받아 두세요. - 실행하지 않고 설정만 만들려면
ollama launch codex --config를, 만든 프로필과 모델 목록을 지우려면ollama launch codex --restore를 씁니다. 손으로 설정한다면codex --oss로 시작하면 됩니다.
측정 쪽은 비대화형인 codex exec --json에 --oss --local-provider ollama를 붙였습니다. 모델 정보로는 ollama launch codex --config --model gpt-oss:20b --yes가 임시 폴더에 만든 model.json을 넘겼고, 사용자 설정은 건드리지 않았어요.
컨텍스트 길이는 얼마로 둬야 할까요?
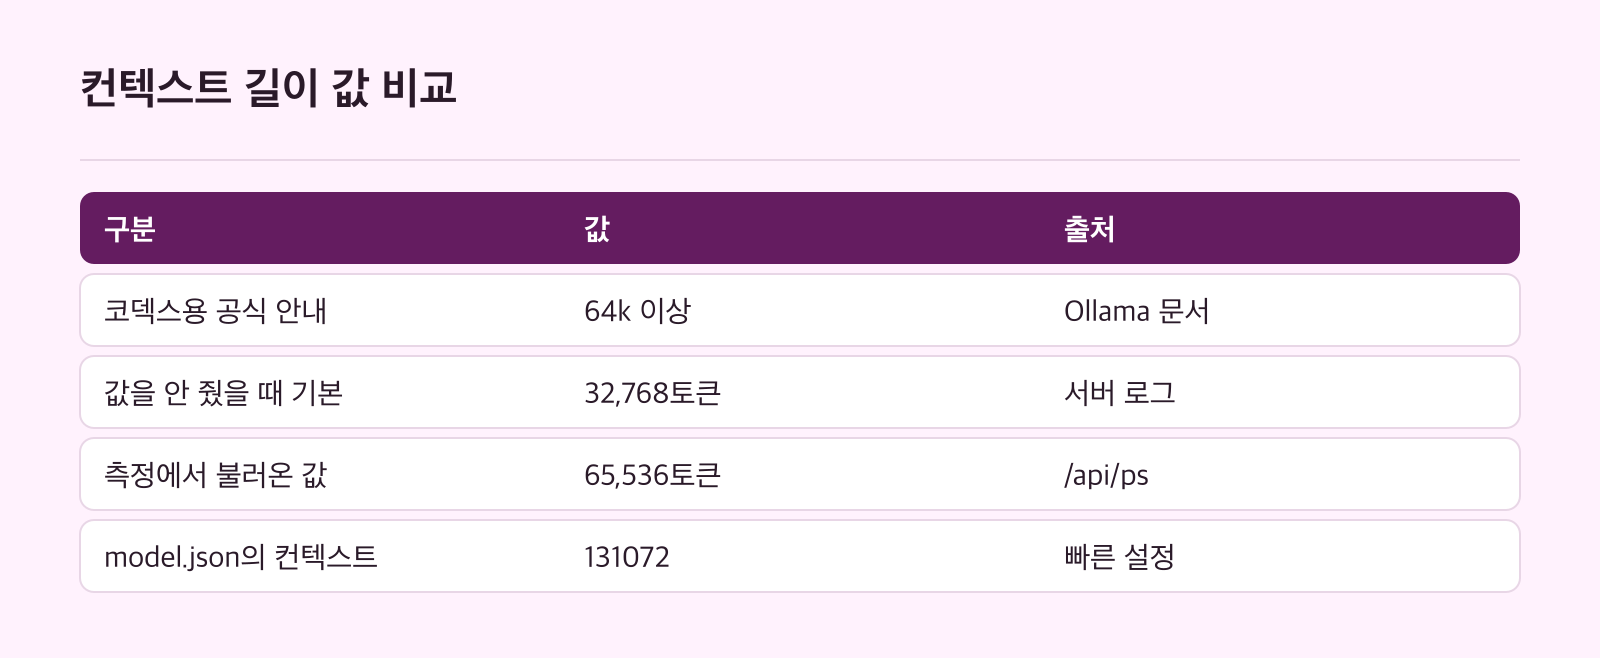
공식 문서는 코덱스에 쓸 때 컨텍스트 창을 64k 토큰 이상으로 두라고 안내합니다. 그런데 이 컴퓨터에서 따로 값을 주지 않으면, Ollama는 서버 로그 기준으로 기본 컨텍스트를 32,768토큰으로 정했습니다. 안내보다 작은 값이죠. 그래서 측정은 서버를 띄울 때 65,536을 줬고, 모델은 실제로 65,536토큰 컨텍스트로 불러와졌습니다(/api/ps 값). 빠른 설정이 만든 model.json에는 context_window가 131072로 적혀 있었어요.
참고로 클라우드 조건에서 코덱스가 보낸 입력 토큰은 중앙값 58,731이었습니다. 반면 로컬 조건은 끊기면서 토큰 기록이 남지 않았습니다. 그러니 이 측정만으로는 끊긴 원인을 가를 수 없습니다. 같은 오류를 만났다면 ~/.ollama/logs/server.log의 서버 로그와 /api/ps로 불러온 컨텍스트 길이부터 확인해 보는 편이 좋겠습니다.
로컬 AI는 언제 쓰면 좋을까요?
혼자 제품을 만들면서 로컬 AI를 고민하고 있다면, 이 측정이 말해 주는 범위는 이렇습니다. 짧은 질문 하나에 답하는 일이라면 이 맥에서 초당 91토큰 이상으로 몇 초 안에 끝났고, API 키도 필요 없었습니다. 예를 들어 앱 안에서 짧은 문장을 만들거나, 코드 조각을 빠르게 물어보는 용도라면 시도해 볼 만합니다.
반면 코덱스처럼 여러 번 도구를 부르며 파일을 고치는 에이전트 작업에서는 gpt-oss:20b가 3번 모두 끝까지 가지 못했습니다. 마감이 걸린 버그 수정이라면 이 측정 기준으로는 클라우드 모델이 안전한 선택입니다. 로컬 모델을 에이전트에 쓰고 싶다면, 테스트가 딸린 작은 작업을 같은 방식으로 몇 번 돌려 보고 결과를 확인한 뒤에 맡기세요. /model로 다른 모델을 골라 같은 작업을 다시 돌려 보는 것도 방법입니다.
측정 조건과 한계
- 맥 한 대(Apple M5 Max, 메모리 36GB)에서 Ollama 0.40.8과 codex-cli 0.163.0-alpha.11.2로 잰 값입니다.
- 작업은 테스트 6개가 딸린 작은 버그 수정 하나였고, 두 조건 모두 기본 추론 강도로 실행했습니다.
- 사용자 설정, 규칙 파일, 플러그인, 앱 연결, 사용자 스킬을 끄고, 작업 폴더에만 쓸 수 있는 샌드박스에서 돌렸습니다.
- 조건마다 3번씩이라 성공률은 거친 값입니다. 더 큰 작업이나 다른 모델, 다른 컴퓨터, 다른 버전에서는 결과가 다를 수 있습니다.
- 로컬 조건은 3회 모두 중간에 끊겨 토큰을 비교할 수 없었고, 걸린 시간도 끊길 때까지의 시간입니다.
참고 자료
- Quickstart docs.ollama.com
- macOS docs.ollama.com
- Codex CLI docs.ollama.com
- GitHub 저장소: ollama/ollama github.com