코딩 AI 추천, 클로드 코드·코덱스·안티그래비티에 같은 기능을 맡겨 보니
코딩 AI 추천을 찾는 1인 개발자를 위해 장바구니 금액 계산 기능을 클로드 코드, 코덱스, 안티그래비티, 로컬 gpt-oss:20b에 3번씩 맡겼습니다. 클로드 코드가 3번 모두 통과했고 중앙값 23.5초로 가장 빨랐습니다. 상황별 선택법과 시작 명령도 함께 담았습니다.
Finn ·
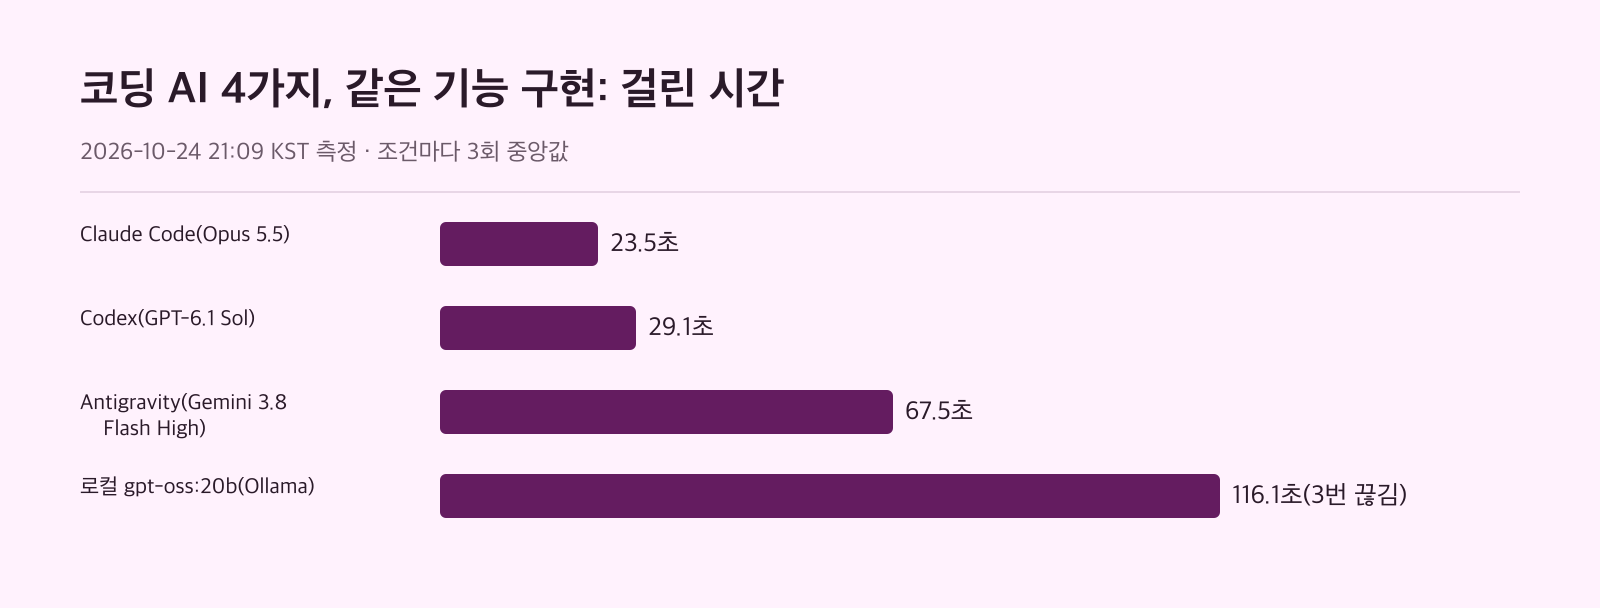
장바구니 주문 금액을 계산하는 기능 하나를 클로드 코드, 코덱스, 안티그래비티, 맥에서 도는 무료 로컬 모델 gpt-oss:20b에 3번씩 맡겼습니다. 테스트 9개를 3번 모두 통과한 건 클로드 코드와 안티그래비티 둘뿐이었고, 걸린 시간 중앙값은 각각 23.5초와 67.5초였어요. 코딩 AI 추천을 찾고 있다면 같은 요청, 같은 테스트로 잰 이 결과부터 보시면 고르기가 한결 쉬워집니다.
측정으로 본 추천은 무엇일까요?
이 과제에서 첫 추천은 Claude Code(Opus 5.5)입니다. 3번 모두 성공했고 걸린 시간도 가장 짧았죠. 두 번째는 Antigravity CLI(Gemini 3.8 Flash High)입니다. 역시 3번 모두 통과했지만, 시간은 클로드 코드의 2.9배, 출력 토큰은 4.4배였습니다.
| 도구(모델) | 성공 | 걸린 시간 | 입력 토큰 | 출력 토큰 | 도구 호출 |
|---|---|---|---|---|---|
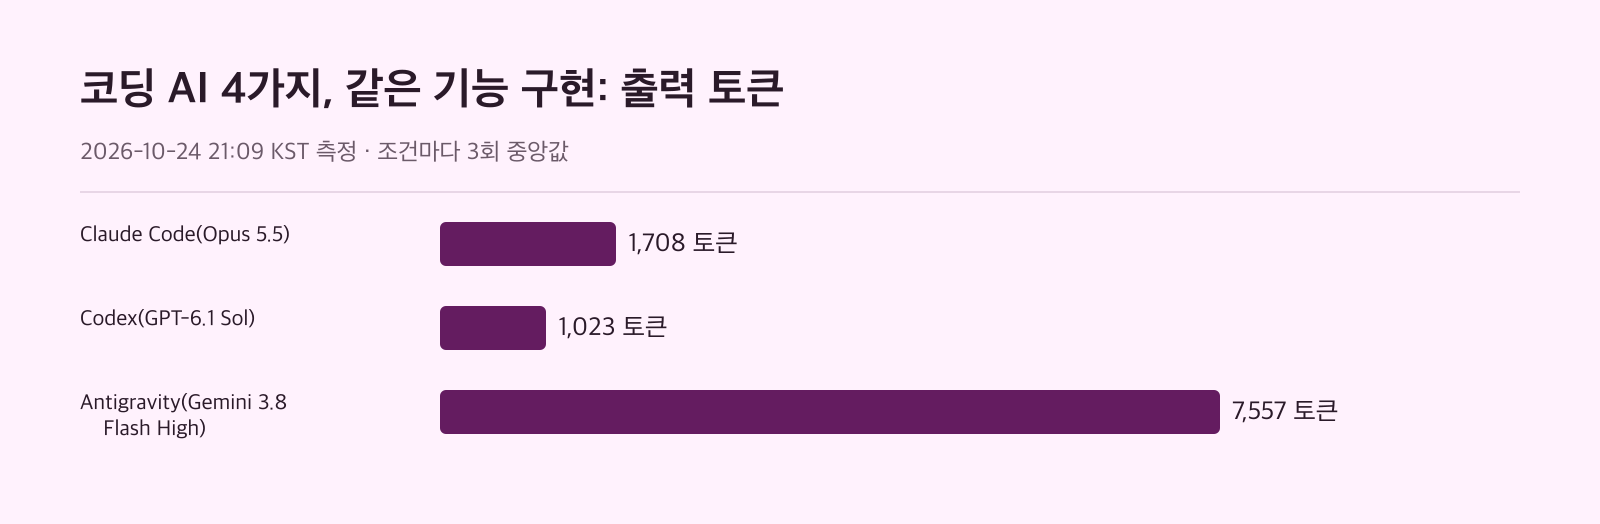
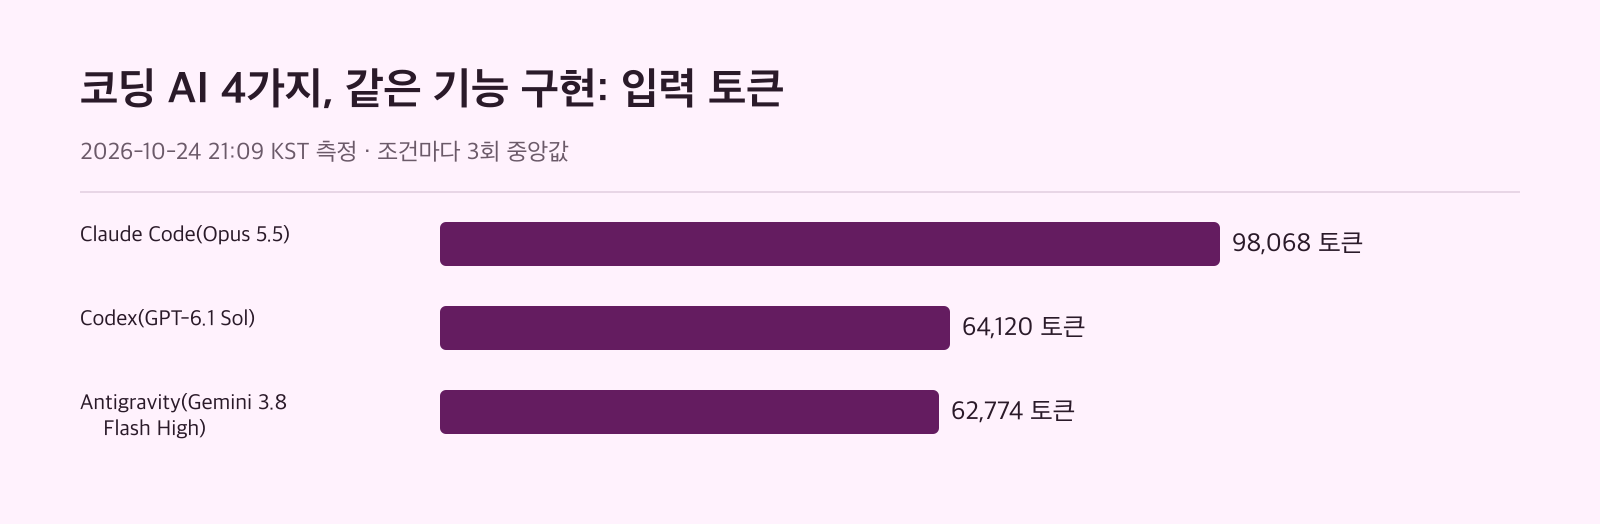
| Claude Code(Opus 5.5) | 3/3 | 23.5초 | 98,068 | 1,708 | 2 |
| Codex(GPT-6.1 Sol) | 0/3 | 29.1초 | 64,120 | 1,023 | 1 |
| Antigravity(Gemini 3.8 Flash High) | 3/3 | 67.5초 | 62,774 | 7,557 | 5 |
| 로컬 gpt-oss:20b(Ollama, 코덱스로 실행) | 0/3, 3번 모두 중간에 끊김 | 116.1초 | 기록 없음 | 기록 없음 | 3 |
모든 값은 3번 실행의 중앙값입니다. Codex(GPT-6.1 Sol)는 시간도 토큰도 적게 썼지만 3번 모두 테스트를 통과하지 못했어요. 그러니 이 과제만 보면 "빠르고 가벼운데 틀린" 결과였던 셈입니다. 그럼 시간과 토큰은 회차마다 얼마나 흔들렸을까요?
함께 읽을 글
걸린 시간과 토큰은 얼마나 달랐나요?
회차별로 보면 클로드 코드는 18.1초에서 26.7초 사이였습니다. 안티그래비티는 61.5초에서 121.7초까지 벌어졌고, 코덱스는 25.9초에서 30.2초, 로컬 모델은 84.6초에서 129.6초였죠. 로컬 모델의 중앙값은 클로드 코드의 4.9배입니다.
출력 토큰은 안티그래비티가 7,557로 가장 많았고 그중 추론 토큰이 6,640이었습니다. 이 측정에서 안티그래비티의 출력 토큰은 추론 토큰을 포함한 값이에요. 첫 회차에서는 출력이 16,203까지 늘었습니다. 클로드 코드는 출력 1,708에 추론 193, 코덱스는 클로드 코드의 0.6배였습니다.
그런데 입력 토큰은 순서가 거꾸로입니다. 클로드 코드가 98,068로 가장 많았지만 그중 88,182가 캐시 읽기였어요. 코덱스는 64,120 중 54,528이 캐시 읽기, 안티그래비티는 62,774였고 중앙값 회차의 캐시 읽기는 0이었습니다. 이 차이가 무엇 때문인지는 이 측정만으로는 가를 수 없습니다. 궁금하다면 자기 저장소에서 같은 요청을 JSON 출력으로 돌려 도구별 사용량 값을 나란히 비교해 보세요.
비용 표시는 클로드 코드만 결과 JSON에 들어 있었고 중앙값은 0.13 USD였습니다. 나머지 도구는 비용 표시가 없어서 이 측정으로 요금을 견줄 수는 없어요.
코덱스와 로컬 모델은 왜 실패했나요?
코덱스는 3번 모두 실행이 끝났지만, 3번 모두 성공 기준(측정 쪽이 돌린 node --test 통과와 테스트 파일 보존)을 충족하지 못했습니다. 테스트를 통과하지 못한 것인지 테스트 파일이 바뀐 것인지는 제공된 기록으로 구분할 수 없어요. 직접 확인하려면 실행 뒤 같은 폴더에서 테스트를 돌려 실패한 항목이 있는지 보고, test/checkout.test.js가 원본과 같은지도 함께 비교하는 편이 좋습니다.
로컬 gpt-oss:20b는 사정이 다릅니다. 3번 모두 코덱스가 "응답이 완료되기 전에 스트림이 끊겼다"는 오류로 턴을 끝냈고, 그래서 토큰 기록도 없죠. 따로 Ollama API로 짧은 질문을 보냈을 때는 답 생성이 초당 89.6, 90.2, 90.0토큰이었습니다. 첫 회차는 모델 불러오기 4.1초를 포함해 7.9초, 그 뒤로는 1.7초와 1.8초였어요. 짧은 답은 잘 나오는데 코딩 작업은 끊긴 셈인데, 이 둘을 잇는 원인도 기록만으로는 알 수 없습니다.
바이브 코딩 툴, 상황별로 고르는 법
AI 코딩을 혼자 돌리는 1인 개발자라면 무엇을 기준으로 골라야 할까요? 측정값과 공식 문서가 말하는 만큼만 정리하면 이렇습니다.
- 결과가 맞아야 할 때: 이 과제에서 3번 모두 통과한 클로드 코드나 안티그래비티가 후보입니다. 둘 중 하나만 고르라면 더 빨랐던 클로드 코드가 낫습니다.
- 빨리 돌려야 할 때: 중앙값으로는 클로드 코드(23.5초)가 가장 빨랐습니다. 코덱스(29.1초)도 가까웠지만 통과하지 못했으니, 빠른 실패는 다시 돌리는 시간만 늘릴 수 있어요.
- 사용량이 걱정될 때: 이 측정만으로는 요금을 비교할 수 없습니다. 클로드 코드는 대부분의 사용 환경에서 Claude 구독이나 Anthropic Console 계정이 필요하고, 안티그래비티 개요 문서는 개인 개발자용으로 무료 등급(Free tier)과 Pro·Ultra 요금제를 적어 둡니다. 토큰만 보면 안티그래비티의 출력이 가장 많았으니, 요금제마다 무엇을 세는지부터 확인하는 편이 좋겠습니다.
- 인터넷 없이 쓸 때: 네 조건 가운데 모델 추론을 로컬 Ollama 서버에서 처리한 것은 gpt-oss:20b 조건입니다. 인터넷을 끊은 상태의 전체 작업 동작은 이 측정에서 검증하지 않았습니다. 다만 이 측정에서는 0/3에 3번 모두 중간에 끊겼어요. 지금은 실제 기능을 맡기기보다 짧은 질문이나 실험에 쓰는 정도로 보는 게 맞습니다. 참고로 Ollama 프로필로 보내는 코덱스의 웹 검색은 Ollama가 처리하고, 이걸 쓰려면
ollama signin으로 로그인해야 합니다.
판단이 섰다면 이제 설치할 차례입니다.
도구마다 시작하는 방법
| 도구 | 실행 명령 | macOS 설치 | 로그인 |
|---|---|---|---|
| Claude Code | claude | 설치 스크립트 또는 Homebrew | 처음 실행할 때 로그인, 또는 API 키 환경 변수 |
| Codex CLI | codex | 설치 스크립트, npm, Homebrew | 처음 실행할 때 Sign in with ChatGPT 등 |
| Antigravity CLI | agy | 개요 문서에는 없음(시작 안내 참고) | 개요 문서에는 없음 |
| 로컬 gpt-oss:20b | ollama launch codex | Codex CLI를 설치한 뒤 Ollama로 연결 | Ollama 웹 검색에만 ollama signin |
클로드 코드는 공식 개요 문서에 나온 대로 설치한 뒤 프로젝트 폴더에서 실행합니다. 처음 실행하면 로그인을 묻고, ANTHROPIC_API_KEY를 설정해 두고 사용을 승인하면 로그인 단계를 건너뜁니다.
curl -fsSL https://claude.ai/install.sh | bashcd your-project
claudeHomebrew로 설치하려면 brew install --cask claude-code를 쓰면 되는데, 이 방식은 자동으로 업데이트되지 않아요.
코덱스는 Codex CLI 문서의 설치 스크립트나 npm으로 설치합니다. 프로젝트 폴더에서 codex를 처음 실행하면 Sign in with ChatGPT 같은 로그인 방법을 고르게 되죠.
curl -fsSL https://chatgpt.com/codex/install.sh | shnpm install -g @openai/codex안티그래비티의 터미널 도구는 agy라는 명령으로 실행합니다. 안티그래비티 개요 문서에는 설치 명령이 없고 시작 안내 페이지로 넘어가게 되어 있으니, 거기서 설치하면 됩니다.
로컬 모델은 코덱스를 설치한 다음 Ollama로 연결합니다. Ollama의 코덱스 연동 문서는 빠른 설정 명령으로 아래를 안내해요.
ollama launch codex이 측정에서는 아래 명령으로 만든 모델 정보를 코덱스에 넘겼습니다. 사용자 설정은 건드리지 않았어요.
ollama launch codex --config --model gpt-oss:20b --yes수동으로 붙이려면 codex --oss를 쓰면 됩니다. Ollama 문서는 코덱스용 컨텍스트 창을 최소 64k 토큰으로 잡으라고 안내합니다. 이 측정은 Ollama 서버를 컨텍스트 65,536토큰으로 띄웠는데, 이 값을 주지 않으면 측정한 컴퓨터(Apple M5 Max, 메모리 36GB)에서는 기본값이 32,768토큰이었습니다. 내려받은 모델 크기는 13.8GB예요.
측정 조건과 한계
같은 조건에서 비교하려고 네 도구를 아래 순서로 돌렸습니다. 직접 실행해 보면 자기 저장소에서도 같은 틀로 비교할 수 있어요.
- 조건마다 작업 폴더를 새 임시 폴더로 복사합니다.
- 같은 한국어 요청을 비대화형으로 한 번 실행합니다(
claude -p,codex exec --json,agy -p, 기본 추론 강도). - 요청에서 명령 실행을 빼고 파일만 고치게 합니다.
- 실행이 끝나면 측정 쪽이
node --test를 돌립니다. - 테스트가 통과하고 테스트 파일이 그대로일 때만 성공으로 셉니다.
- 조건마다 3번씩 번갈아 실행해 중앙값을 씁니다.
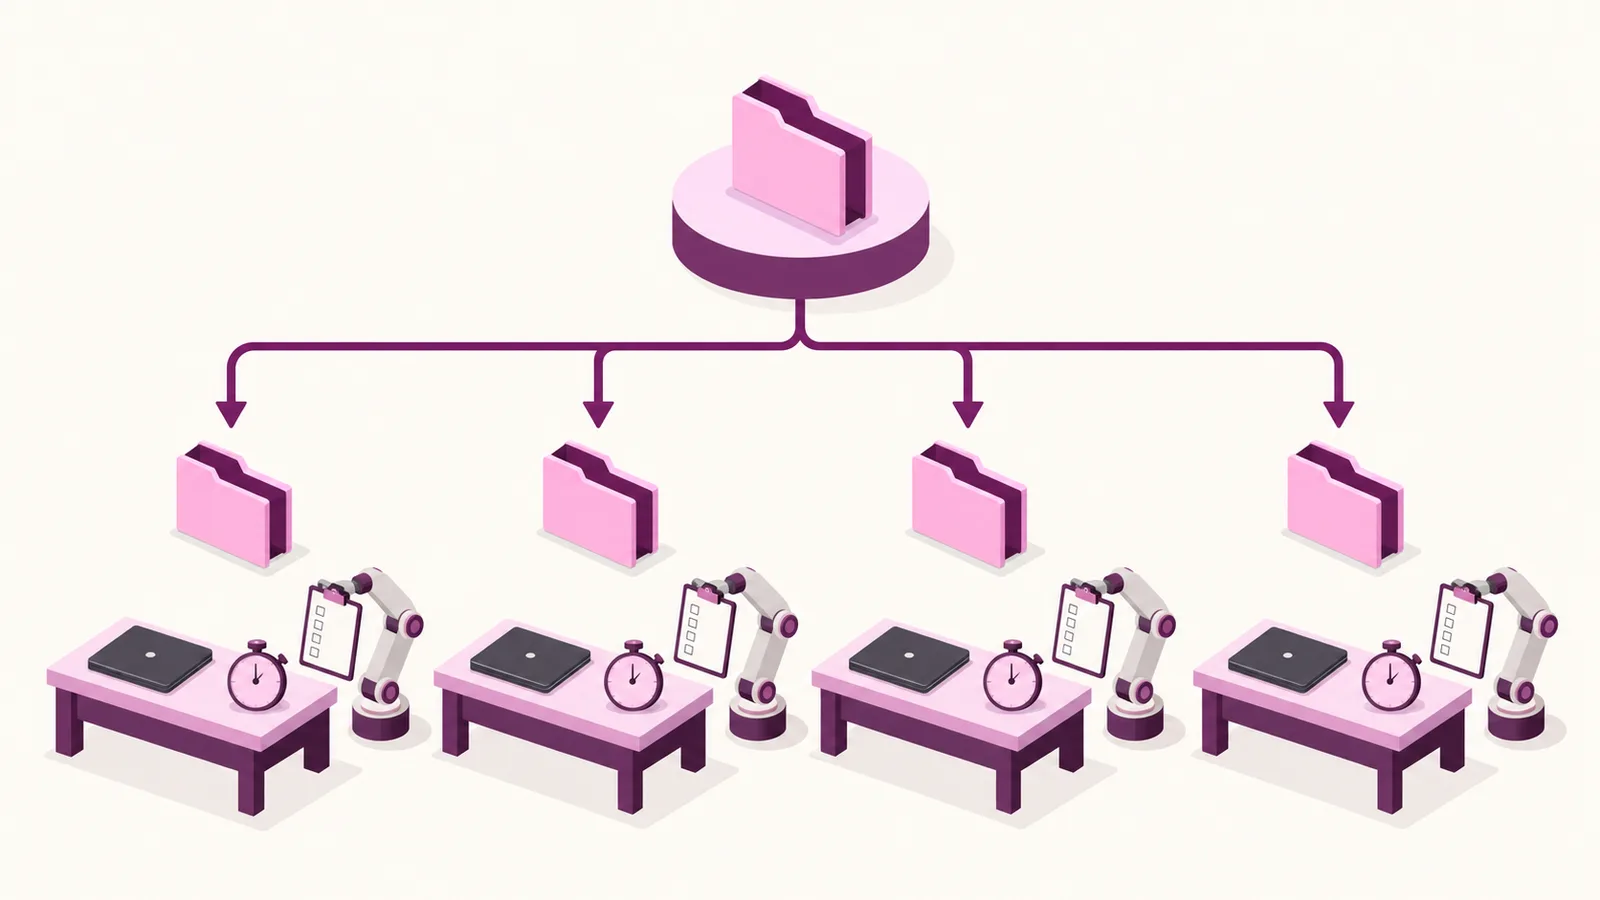
요청은 src/checkout.js에 쿠폰 두 종류, 할인 상한, 무료 배송 기준, 수량 검사까지 규칙 8가지를 담은 함수를 만드는 일이었습니다. 클로드 코드는 사용자 설정·사용자 스킬·플러그인·훅·MCP 서버를 불러오지 않고 돌렸고, 코덱스는 사용자 설정·규칙 파일·플러그인·앱 연결·사용자 스킬을 끈 채 작업 폴더에만 쓸 수 있는 샌드박스에서 돌렸어요. 안티그래비티는 권한 설정을 바꾸지 않았고 MCP 서버나 플러그인도 붙어 있지 않았습니다.
그렇다면 이 결과를 어디까지 믿어야 할까요? 자바스크립트 함수 하나짜리 작은 과제였기 때문에 큰 프로젝트, 다른 언어, 다른 요청에서는 순서가 바뀔 수 있습니다. 조건마다 3번씩이라 성공률도 거친 값이에요. 로컬 모델의 속도는 측정한 컴퓨터에서 잰 값이고, 도구들이 평소처럼 명령을 직접 실행하며 고치는 방식에서는 결과가 다를 수 있습니다. 내 제품에 맞는 답이 필요하다면 자주 맡기는 작업 하나를 골라 같은 순서로 몇 번 돌려 보세요.
참고 자료
- Overview code.claude.com
- Codex CLI learn.chatgpt.com
- Choose your Antigravity antigravity.google
- Codex CLI docs.ollama.com