클로드 코드(Claude Code) effort 차이, 단계별 고르는 법
클로드 코드 effort를 low부터 max까지 바꿔 같은 장바구니 버그 수정을 단계마다 3번씩 시킨 결과입니다. 다섯 단계 모두 성공했고 max는 low보다 시간이 3.5배, 출력 토큰이 4.6배 들었습니다. 단계 고르는 법과 클로드 코드에서 바꾸는 법도 함께 담았습니다.
Finn · · 수정
장바구니 금액 계산 함수의 버그를 고치는 같은 작업을 클로드 코드 effort만 바꿔 맡기면 결과가 얼마나 달라질까요? low는 22.8초, max는 80.7초가 걸렸고, 다섯 단계 모두 3번 중 3번 테스트를 통과했습니다. 이 정도 작업이라면 low·medium으로도 충분했고, 비용 표시(중앙값)는 low가 0.14달러, max가 0.34달러였습니다.
클로드 코드 effort 차이 한눈에 보기
같은 작업에서 다섯 단계 모두 성공했고, 차이는 걸린 시간과 토큰에서 났습니다. low와 비교한 걸린 시간은 medium 1.3배, high 1.5배, xhigh 1.6배였고, max는 출력 토큰 4.6배, 걸린 시간 3.5배, 입력 토큰 2.2배였습니다. 모델 설정 문서도 낮은 단계는 단순한 작업에서 더 빠르고 저렴하고, 높은 단계는 복잡한 문제에서 더 깊게 추론한다고 설명합니다.
함께 읽을 글
단계별로 시간과 토큰은 얼마나 늘었나요?
결론부터 말하면, 이 작은 작업에서는 low로도 매번 성공했고 max만 눈에 띄게 무거웠습니다. 모델은 claude-opus-5-5 하나였고, 아래 값은 모두 단계별 3회 측정의 중앙값입니다.
| 단계 | 성공 | 걸린 시간 | 입력 토큰 | 출력 토큰 | 추론 토큰 | 도구 호출 |
|---|---|---|---|---|---|---|
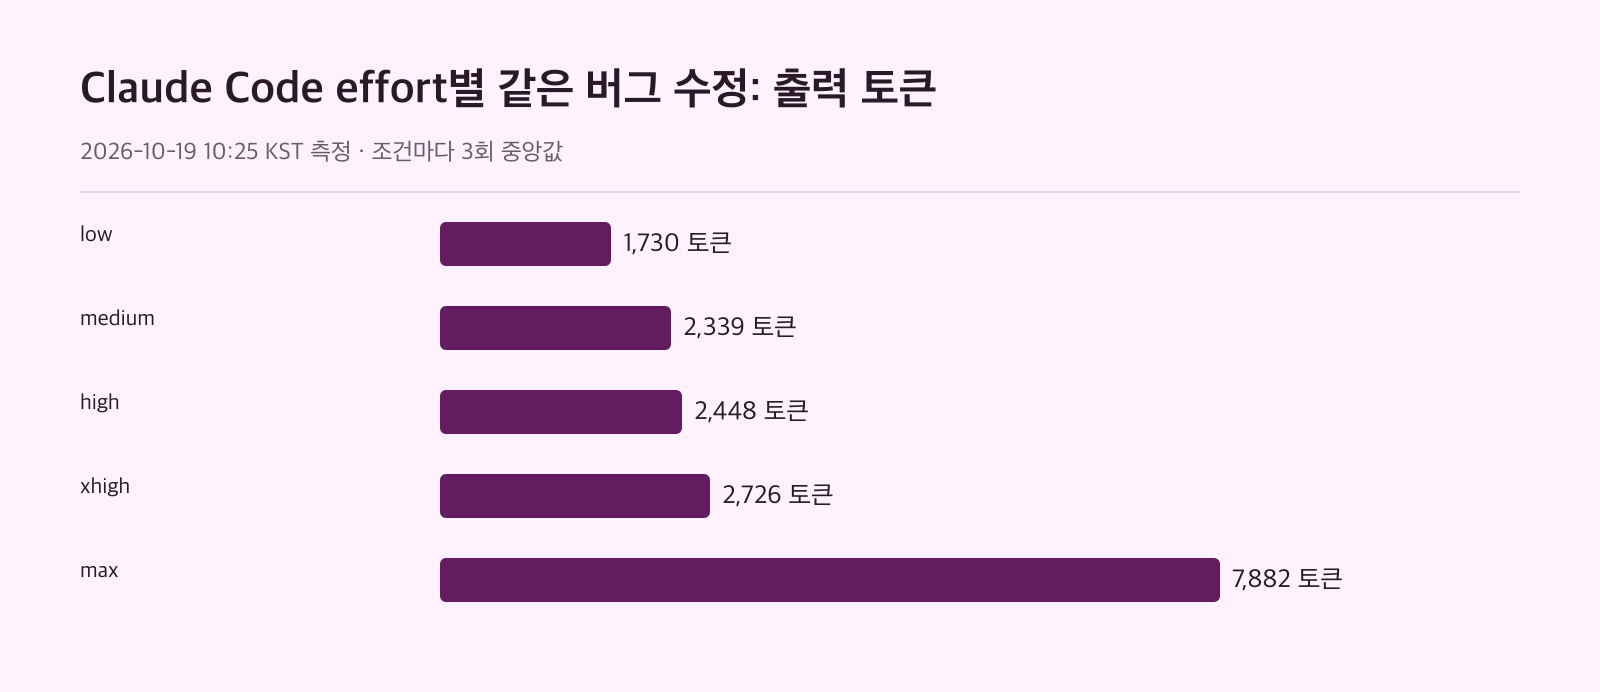
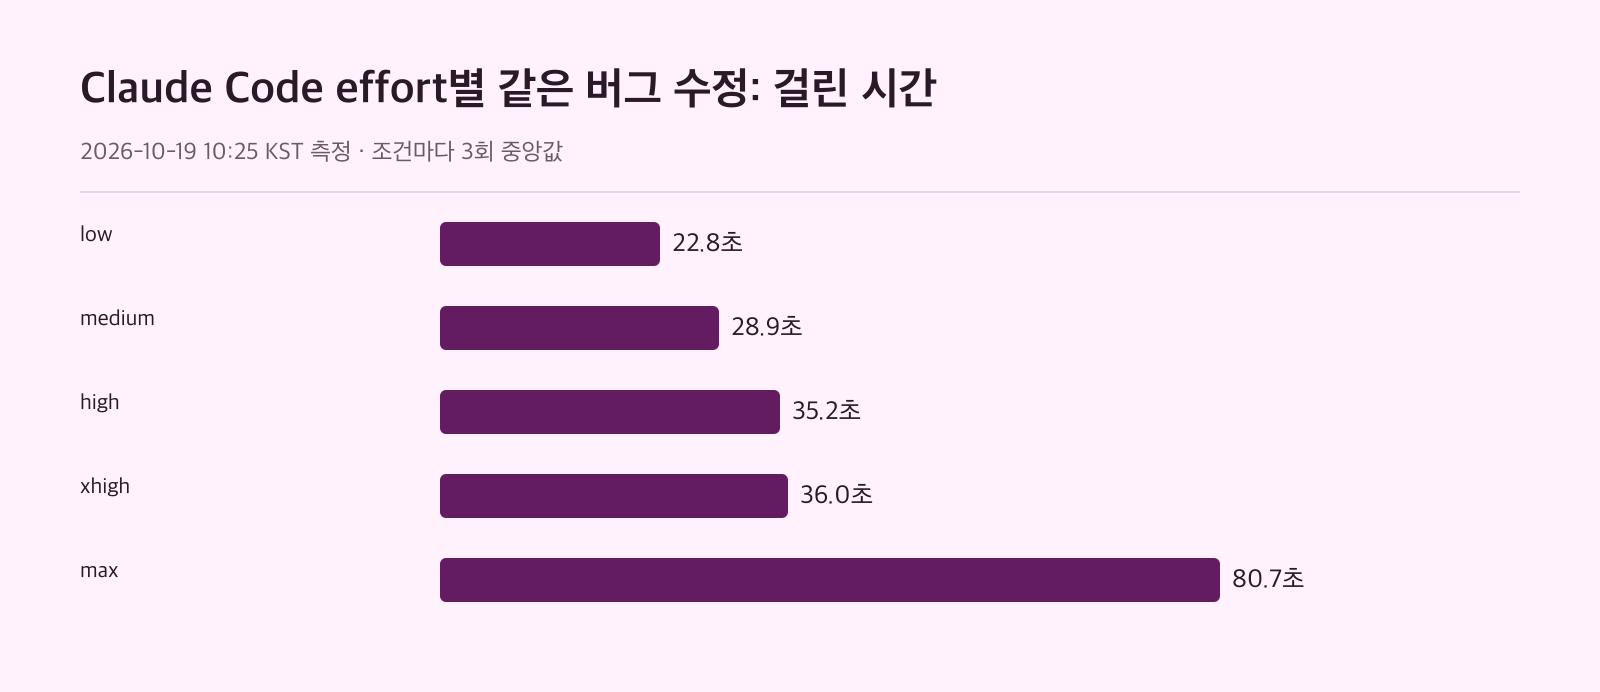
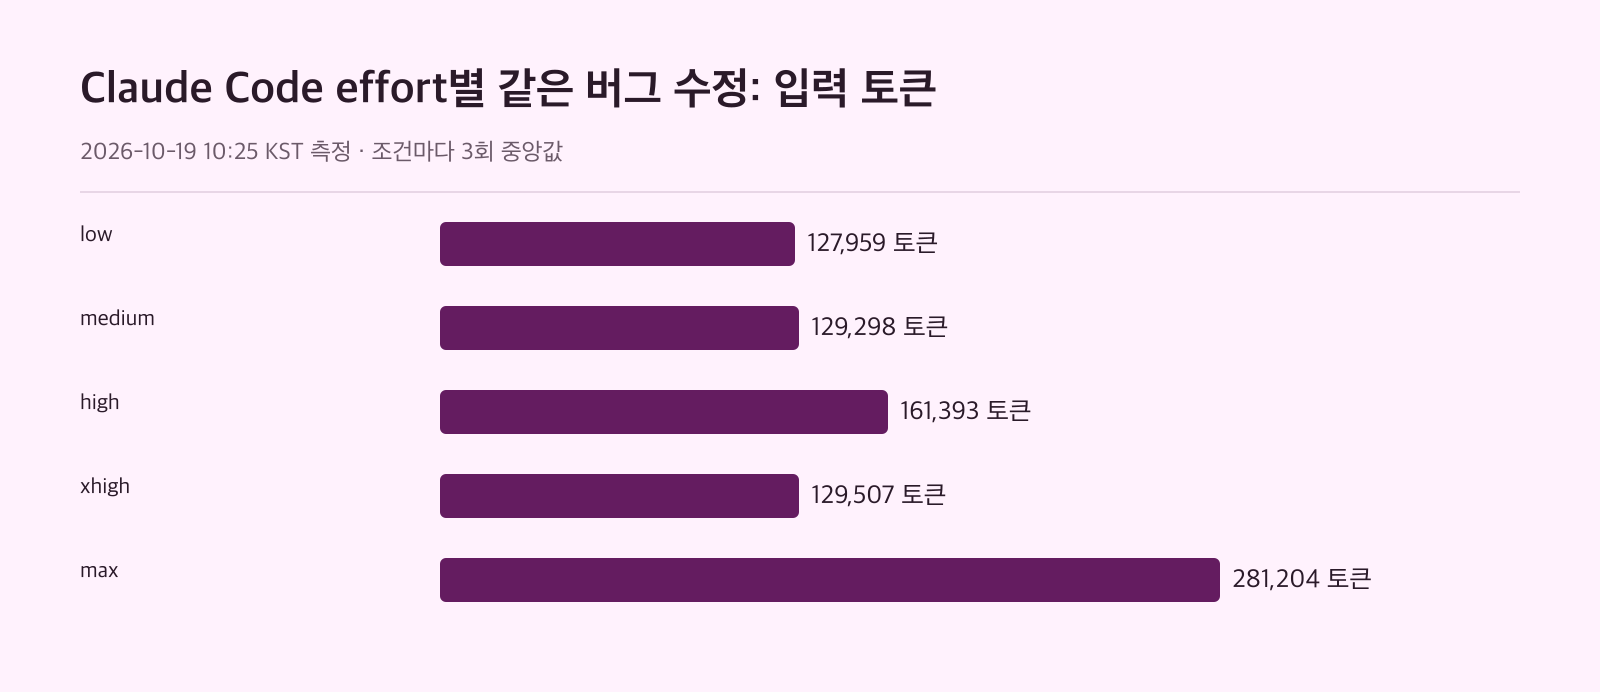
| low | 3/3 | 22.8초 | 127,959 | 1,730 | 67 | 5 |
| medium | 3/3 | 28.9초 | 129,298 | 2,339 | 168 | 4 |
| high | 3/3 | 35.2초 | 161,393 | 2,448 | 263 | 5 |
| xhigh | 3/3 | 36.0초 | 129,507 | 2,726 | 610 | 4 |
| max | 3/3 | 80.7초 | 281,204 | 7,882 | 5,184 | 11 |
low와 견주면 medium은 출력 토큰 1.4배에 시간 1.3배, high는 출력 1.4배에 시간 1.5배, xhigh는 둘 다 1.6배였습니다. 그런데 max에서는 출력 토큰 4.6배, 걸린 시간 3.5배, 입력 토큰 2.2배로 한꺼번에 뛰었죠. 성공률은 모든 단계가 같았으니, 적어도 이 작업에서는 토큰을 더 써도 성공 여부는 달라지지 않았습니다.
출력 토큰만 따로 보면 low의 1,730에서 xhigh의 2,726까지는 완만하게 올랐습니다. 반면 max에서는 7,882로 크게 늘었습니다.
회차마다 값이 얼마나 흔들렸나요?
걸린 시간도 비슷한 모양입니다. low부터 xhigh까지는 22.8초에서 36.0초 사이였고, high(35.2초)와 xhigh(36.0초)는 거의 같았어요. max만 80.7초로 따로 떨어져 있습니다.
그런데 같은 단계 안에서도 값은 꽤 흔들렸습니다. 예를 들어 high 3회차는 19.5초에 입력 토큰 96,085로, 다른 두 회차(35.2초, 35.3초)보다 훨씬 가벼웠습니다. medium 2회차의 입력 토큰은 163,566, xhigh 2회차는 194,931로 같은 단계의 다른 회차보다 컸고요. high는 1·2회차가 161,393과 161,968로 무거웠고, xhigh는 1·3회차가 129,507과 127,732로 가벼웠습니다. 그래서 중앙값으로는 high(161,393)가 xhigh(129,507)보다 많게 나왔습니다. 3회 측정에서는 회차 한 번이 단계 사이 순서를 뒤집을 수 있다는 뜻입니다.
입력 토큰의 대부분은 캐시 읽기였습니다. max 중앙값 281,204 가운데 265,664가 캐시 읽기였죠. 그렇다면 max에서 도구 호출이 11번으로 늘어난 것이 입력 토큰을 키운 걸까요? 이 측정만으로는 원인을 가를 수 없습니다. 확인하고 싶다면 같은 조건을 더 여러 번 돌린 뒤, 회차별 결과 JSON의 usage 값을 도구 호출 수와 나란히 놓고 비교해 보세요.
추론 토큰은 어디서 크게 뛰었나요?
추론(thinking) 토큰은 중앙값 기준으로 단계마다 늘었습니다. low 67, medium 168, high 263, xhigh 610까지 올라간 뒤 max에서 5,184가 됐습니다. 접혀 있거나 가려져 표시되는 추론 토큰도 모두 요금에 포함된다는 점이 모델 설정 문서에 적혀 있습니다. 화면에 안 보인다고 해서 비용에서 빠지지는 않는다는 뜻이죠.
Claude Code effort는 무엇을 조절하나요?
모델 설정 문서는 effort 단계가 적응형 추론(adaptive reasoning)을 조절한다고 적고 있습니다(원문: "control adaptive reasoning, which lets the model decide whether and how much to think on each step based on task complexity"). 작업 복잡도에 따라 단계마다 생각할지, 얼마나 생각할지를 모델이 정하게 하는 설정이라는 뜻입니다. 같은 문서의 단계별 용도표를 보면, low는 브레인스토밍이나 이름 바꾸기처럼 결과를 하나씩 검토하는 작은 변경에 맞습니다. high는 기존 코드베이스의 버그 수정처럼 검증이 중요한 작업에, xhigh는 토큰을 더 많이 쓰면서 더 깊게 추론해야 할 때 쓰라고 안내합니다. 낮은 단계는 단순한 작업에서 더 빠르고 저렴하고, 높은 단계는 복잡한 문제에서 더 깊게 추론합니다. 이 측정에 쓴 Opus 5.5는 기본값이 medium입니다. 같은 문서는 max를 가장 깊게 추론하는 단계라고 소개하고, CLAUDE_CODE_EFFORT_LEVEL 환경 변수로 정하지 않으면 Claude Code가 max를 현재 세션에만 적용한다고 적고 있습니다.
그렇다면 effort는 정확히 무엇을 바꾸는 설정일까요? 모델마다 쓸 수 있는 단계와 기본값이 다르니, 그 부분부터 짚겠습니다.
effort가 조절하는 것과 모델별 기본값
공식 문서에 따르면 effort는 적응형 추론(adaptive reasoning)을 조절합니다. 모델이 작업의 복잡도를 보고 단계마다 생각을 할지, 얼마나 할지를 정하는 방식입니다. 낮은 단계는 단순한 작업에서 더 빠르고 저렴하고, 높은 단계는 복잡한 문제를 더 깊게 추론합니다.
| 모델 | 쓸 수 있는 단계 | 기본값 |
|---|---|---|
| Opus 5.5, Sonnet 5.5, Haiku 5.5 | low~max 다섯 단계 | medium |
모델이 지원하지 않는 단계를 고르면, 고른 단계 이하에서 지원하는 가장 높은 단계로 내려갑니다. 또 effort 척도는 모델마다 따로 맞춰져 있어서, 이름이 같은 단계라도 모델이 다르면 실제 값은 같지 않습니다. 그래서 이번 숫자를 다른 모델에 그대로 옮겨 적용할 수는 없습니다.
effort 단계를 바꾸는 방법
여러 곳에서 정해 두었다면 클로드 코드는 아래 순서에서 먼저 해당하는 값을 씁니다.
- 직접 고른 값: 환경 변수
CLAUDE_CODE_EFFORT_LEVEL, 실행할 때 붙인--effort, 세션 안의/effort - 설정에 저장한 값: 모델별
modelSettings또는effortLevel키 - 모델 기본값
실제로 바꾸는 방법은 다음과 같습니다.
/effort: 인자 없이 실행하면 슬라이더가 열리고, 뒤에 단계 이름을 붙이면 바로 바뀝니다./effort auto는 현재 모델에 저장한 단계를 지웁니다. 슬라이더에서Enter를 누르면 기본값으로 저장되고,s를 누르면 이번 세션에만 적용됩니다(v2.1.257 이상)./model: 모델을 고를 때 좌우 화살표로 effort 슬라이더를 움직입니다.--effort: 실행할 때 단계 이름을 넘기면 그 세션에만 적용됩니다.- 설정 파일:
modelSettings에 모델별 단계를 두거나effortLevel을low·medium·high·xhigh중 하나로 둡니다. 두 키 모두max는 받지 않습니다. - 스킬·서브에이전트: 마크다운 파일의 frontmatter에
effort를 적으면 그 스킬이나 서브에이전트가 돌 때만 세션 단계를 덮어씁니다. 다만CLAUDE_CODE_EFFORT_LEVEL보다 우선하지 않으며,maxEffortLevel과 조직 상한 안에서 적용됩니다.
주의할 점도 있습니다. max는 CLAUDE_CODE_EFFORT_LEVEL로 정하지 않는 한 현재 세션에만 적용됩니다. -p 실행 안에서 쓴 /effort도 그 세션에만 적용되고요. 그리고 Opus 5.5에서는 사용자 설정 파일 최상위에 둔 effortLevel이 적용되지 않으니, /effort나 /model로 따로 골라 줘야 합니다(프로젝트·로컬·관리형(managed) 설정 파일이나 --settings로 넘긴 최상위 effortLevel은 Opus 5.5를 포함한 모든 모델에 적용됩니다). 지금 어떤 단계로 돌고 있는지는 세션 헤더의 모델 이름 옆(예: "with low effort")에서 확인할 수 있습니다.
작업 크기에 맞는 단계 고르는 법
문서가 권하는 쓰임새와 이번 측정 결과를 나란히 놓으면 이렇습니다.
| 단계 | 문서가 권하는 작업 | 이번 측정 |
|---|---|---|
| low | 결과를 매번 검토하는 빠른 작업, 이름 바꾸기 같은 작은 변경 | 22.8초, 3/3 성공 |
| medium | Opus 5.5 기본값, 범위가 분명한 일상 개발 | 28.9초, 3/3 성공 |
| high | 검증이 중요하거나 예외 상황이 많은 기존 코드의 버그 수정 | 35.2초, 3/3 성공 |
| xhigh | 토큰을 더 쓰는 깊은 추론 | 36.0초, 3/3 성공 |
| max | 혼자 맡겨 둘 어려운 문제(보안 취약점 찾기 등) | 80.7초, 3/3 성공 |
문서는 max가 투입 대비 얻는 것이 줄어들 수 있고 과하게 생각하는 경향이 있다며, 널리 쓰기 전에 먼저 시험해 보라고 권합니다. 또 Opus 5.5와 Fable 5.1에서 한 시험에서는 높은 단계일수록 예외 상황을 더 많이 시험하고 답하기 전에 더 많이 검증했다고 합니다. 반대로 낮은 단계는 출발점을 더 빨리 내놓았고요.
그래서 혼자 AI 에이전트로 제품을 만들고 있다면 이렇게 판단해 볼 수 있습니다.
- 테스트가 정답을 정해 둔 작은 수정이라면 기본값
medium이나low로 먼저 시켜 보고, 실패할 때만 단계를 올려 보세요. 이번 측정에서는 low도 3번 모두 통과했습니다. - 테스트가 없거나 예외 상황이 많은 기존 코드의 버그라면 문서가 권하는
high부터 시작하는 편이 안전합니다. max는 세션 하나에만 켜서 쓰세요. 한 번만 깊게 생각하게 하고 싶다면 프롬프트에ultrathink를 넣는 방법도 있습니다. 세션의 effort 설정은 바꾸지 않습니다.- Opus 5에서 Opus 5.5로 옮겼다면 쓰던 단계를 그대로 가져가지 말고
medium에서 시작하라고 문서가 권합니다.
측정 조건과 한계
측정 환경은 Claude Code 2.1.303, darwin arm64, Node.js v22.23.1이었습니다. 단계마다 작업 폴더를 새 임시 폴더로 복사한 뒤 claude -p로 아래 요청 하나를 비대화형으로 실행했고, 단계를 번갈아 가며 3번씩 돌렸습니다. 사용자 설정·스킬·플러그인·훅·MCP 서버는 불러오지 않았습니다(--setting-sources project, --strict-mcp-config). 파일 수정은 --permission-mode acceptEdits로 자동 허용했고, 실행할 수 있는 명령은 node --test 하나뿐이었습니다. 성공은 실행이 끝난 뒤 node --test가 통과하고 테스트 파일이 그대로일 때만 셌습니다.
test/cart.test.js의 테스트가 모두 통과하도록 src/cart.js를 고쳐 주세요. 테스트 파일은 고치지 마세요. 고친 뒤 node --test로 확인해 주세요.한계도 분명합니다. 함수 네 개짜리 파일 하나와 테스트 6개짜리 작업을 Opus 5.5 한 모델로 잰 결과라서, 큰 작업이나 다른 모델에서는 결과가 다를 수 있습니다. 고칠 버그는 다섯 가지(정률 할인 버림, 정액 할인 0원 하한, 5만 원 경계, 할인 뒤 금액으로 배송비 판단, 빈 장바구니의 합계 0원 처리)입니다. 비용 표시는 결과 JSON의 total_cost_usd 값이고, 중앙값은 low 0.14달러, medium 0.16달러, high 0.17달러, xhigh 0.17달러, max 0.34달러였습니다. 회차별로는 low가 0.130.14달러, max가 0.310.36달러였죠. 이와 별개로, 비용 관리 문서에 따르면 /usage에 나오는 세션 비용도 API 사용자를 위한 정가 기준 추정치이고, Pro·Max 구독자에게는 청구와 관계없는 수치입니다. 구독으로 쓰고 있다면 달러 표시보다 걸린 시간과 토큰 수를 기준으로 단계를 비교하는 편이 좋습니다.
자기 작업에서 직접 비교해 보고 싶다면, 테스트가 있는 작업 하나를 임시 폴더에 복사해 --effort로 단계만 바꿔 여러 번 실행해 보세요. 성공 여부와 걸린 시간, 토큰을 함께 적어 두면 어느 단계부터 값이 크게 뛰는지 확인할 수 있습니다.
참고 자료
- Model configuration code.claude.com
- Manage costs effectively code.claude.com