Base64 인코딩·디코딩, macOS 터미널로 직접 해 보니
base64로 바꾸면 PNG 아이콘은 33.5%, JPEG와 WebP는 33.3% 커졌습니다. 맥 터미널 명령과 도구별 결과 차이, 패딩·한글·줄바꿈 오류를 직접 실행한 출력으로 확인합니다.
Finn ·
맥 터미널에서 32×32 PNG 아이콘을 base64로 바꾸면 1396바이트가 1864바이트가 되고, 가로 1200px JPEG 사진은 196404바이트가 261872바이트가 됩니다. 그런데 같은 사진을 맥 base64, openssl, 파이썬, Node로 바꾸면 결과 해시가 세 가지로 갈립니다. AI 코딩 도구가 만들어 준 변환 명령을 그대로 쓰고 있다면, 이 차이와 디코딩 오류가 어디서 생기는지 실제 출력으로 확인해 보세요.
Base64란 무엇이고 맥에서는 어떻게 쓰나요?
Base64는 바이트를 A-Z, a-z, 0-9, +, / 64글자로만 적는 방법입니다. RFC 4648에 따르면 3바이트(24비트)를 6비트씩 네 묶음으로 나눠 4글자로 적습니다. 그래서 MDN 용어 사전도 결과가 보통 원본보다 3분의 1쯤 커진다고 설명하죠.
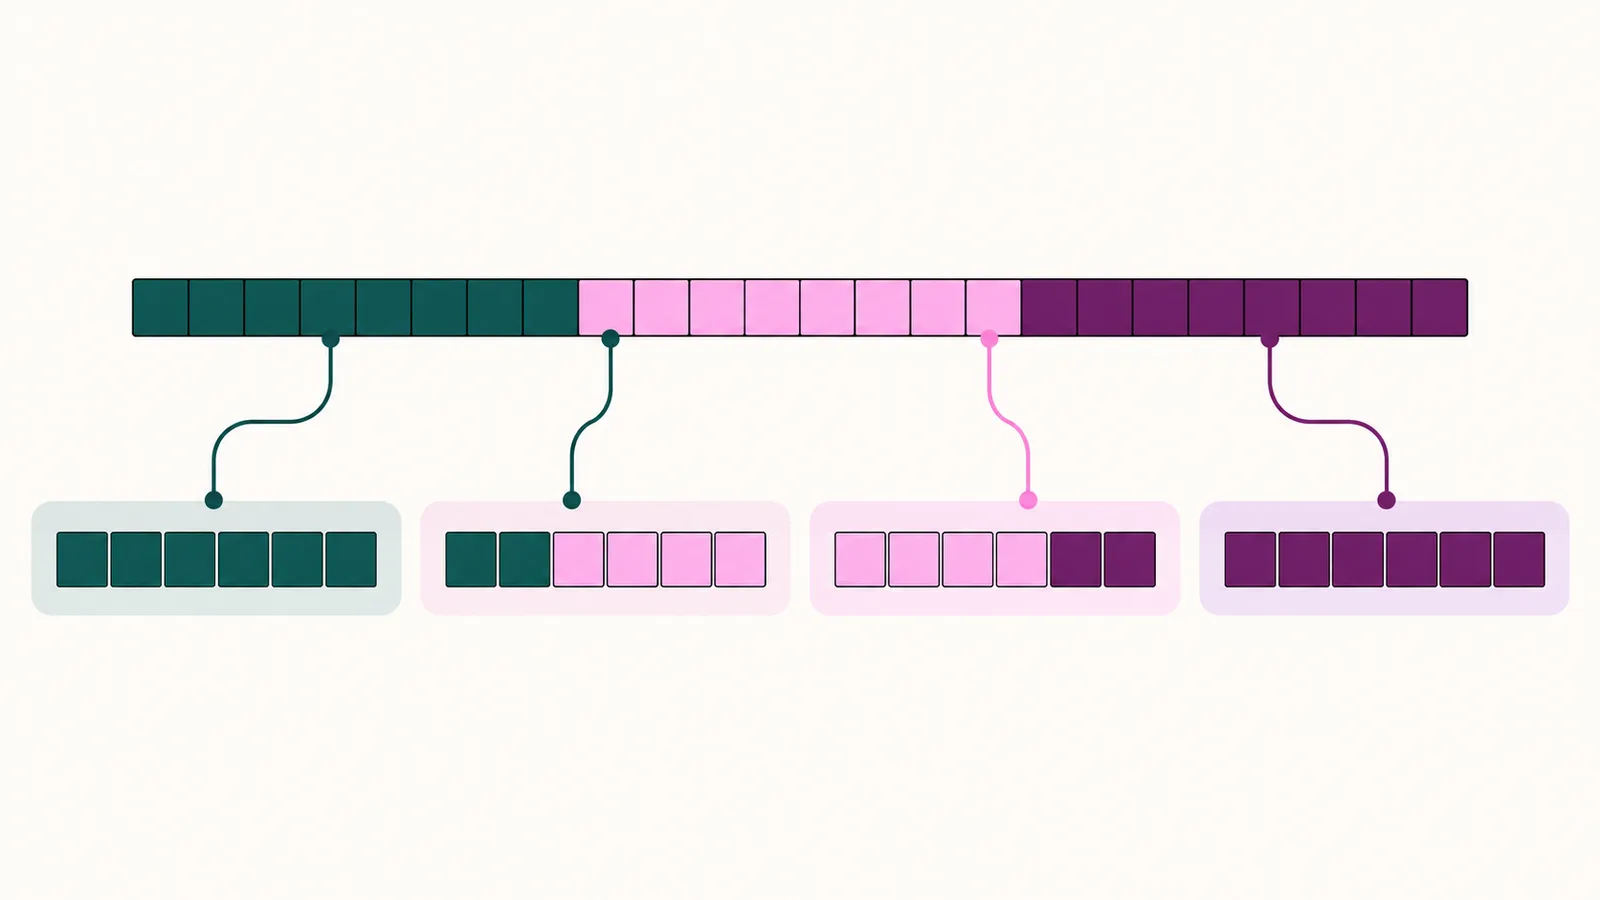
끝에서 바이트가 모자라면 =로 채웁니다. 마지막에 1바이트가 남으면 2글자 뒤에 ==가, 2바이트가 남으면 3글자 뒤에 =가 붙습니다. 열쇠 없이 규칙만 알면 되돌릴 수 있으니 암호화로 쓰면 안 됩니다.
맥에서는 따로 설치할 것 없이 바로 됩니다. 글자는 파이프로 넘기고, 되돌릴 때는 -d를 붙이면 되죠.
$ printf 'Hello' | base64 && printf 'SGVsbG8=' | base64 -d && echo && printf 'Hi' | base64 && printf 'H' | base64
SGVsbG8=
Hello
SGk=
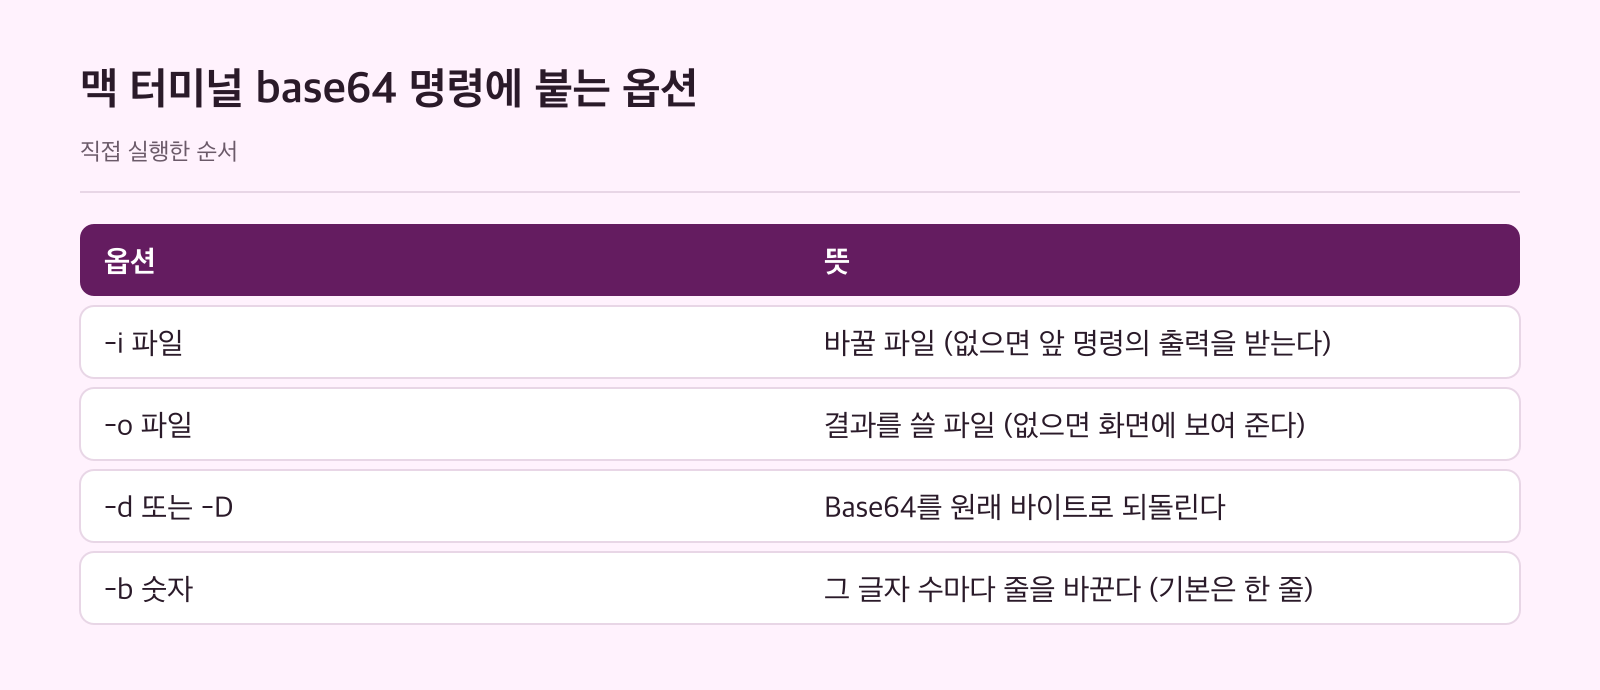
SA==Hello(5바이트)와 Hi(2바이트)는 =가 하나, H(1바이트)는 == 두 개가 붙었습니다. 파일은 base64 -i 파일 -o 결과 꼴로 바꿉니다. 그렇다면 이 옵션들은 어디서나 같을까요?
함께 읽을 글
맥에 들어 있는 명령의 옵션
맥의 base64는 버전을 물으면 FreeBSD base64라고 답합니다. 도움말에는 이렇게 나옵니다.
$ base64 --version && base64 -h
FreeBSD base64
Usage:	base64 [-Ddh] [-b num] [-i in_file] [-o out_file]
  -b, --break       break encoded output up into lines of length num
  -D, -d, --decode  decode input
  -h, --help        display this message
  -i, --input       input file (default: "-" for stdin)
  -o, --output      output file (default: "-" for stdout)
정리하면 -i는 읽을 파일, -o는 쓸 파일, -d와 -D는 둘 다 되돌리기, -b는 한 줄 길이입니다. 그런데 FreeBSD 설명서의 현재 base64 항목은 base64 [-d] [-w column] [file] 꼴이고, 거기서 -i는 GNU base64와 맞추려고 받기만 하고 무시하는 --ignore-garbage입니다. 같은 글자의 옵션이 다른 뜻일 수 있으니, 에이전트가 짠 스크립트를 다른 환경에서 돌린다면 그 환경의 -h 출력부터 확인하는 편이 안전합니다.
한글 문장의 문자셋별 차이
옵션을 알았으니 이제 한글을 넣어 볼 차례입니다. 같은 문장이라도 어떤 문자셋의 바이트로 바꾸느냐에 따라 결과가 완전히 달라집니다.
$ printf '안녕하세요 솔로개발노트' | wc -c && printf '안녕하세요 솔로개발노트' | base64 && printf '안녕하세요 솔로개발노트' | iconv -f UTF-8 -t EUC-KR | wc -c && printf '안녕하세요 솔로개발노트' | iconv -f UTF-8 -t EUC-KR | base64
      34
7JWI64WV7ZWY7IS47JqUIOyGlOuhnOqwnOuwnOuFuO2KuA==
      23
vsiz58fPvLy/5CC81rfOsLO537Prxq4=
UTF-8로는 34바이트, EUC-KR로는 23바이트였고 Base64 문자열도 서로 다릅니다. Base64는 글자가 아니라 바이트를 적는 방법이니까요. 그래서 한글을 Base64로 주고받는 API라면 보내는 쪽과 받는 쪽이 같은 문자셋을 쓰는지부터 맞춰 두는 편이 좋습니다.
이미지 파일은 실제로 얼마나 커질까요?
맥에 들어 있는 문서 아이콘을 32×32 PNG로, 기본 배경화면 사진을 가로 1200px JPEG로 줄이고, 그 사진을 cwebp로 WebP로 바꿨습니다. 크기는 줄바꿈을 뺀 Base64 바이트 수로 쟀습니다.
$ for f in icon.png photo.jpg photo.webp; do base64 -i $f -o $f.b64; o=$(wc -c < $f); e=$(tr -d '\n' < $f.b64 | wc -c); awk -v f=$f -v o=$o -v e=$e 'BEGIN { printf "%s 원본 %d바이트 → Base64 %d바이트 (%.1f%% 늘어남)\n", f, o, e, (e / o - 1) * 100 }'; done
icon.png 원본 1396바이트 → Base64 1864바이트 (33.5% 늘어남)
photo.jpg 원본 196404바이트 → Base64 261872바이트 (33.3% 늘어남)
photo.webp 원본 87006바이트 → Base64 116008바이트 (33.3% 늘어남)| 파일 | 원본 | Base64 | 늘어난 비율 |
|---|---|---|---|
| PNG 아이콘 | 1396바이트 | 1864바이트 | 33.5% |
| JPEG 사진 | 196404바이트 | 261872바이트 | 33.3% |
| WebP 사진 | 87006바이트 | 116008바이트 | 33.3% |
이 값은 이 맥에서 이 파일들로 한 번 잰 것이라 파일마다 달라집니다. MDN도 정확한 증가 폭은 길이, 3으로 나눈 나머지, 패딩 여부 같은 요인에 따라 다르다고 설명합니다. 형식(PNG, JPEG, WebP)과 상관없이 비슷하게 늘어났다는 점이 눈여겨볼 부분이죠.
도구마다 결과가 다른 이유는 줄바꿈
크기는 확인했으니, 이제 결과 문자열 자체가 같은지 볼 차례입니다. 먼저 -b 76으로 줄을 나누면 어떻게 되는지 보세요.
$ base64 -b 76 -i icon.png -o icon76.b64 && head -3 icon76.b64 && wc -l < icon76.b64 && wc -l < icon.png.b64
iVBORw0KGgoAAAANSUhEUgAAACAAAAAgCAYAAABzenr0AAAABGdBTUEAALGPC/xhBQAAACBjSFJN
AAB6JgAAgIQAAPoAAACA6AAAdTAAAOpgAAA6mAAAF3CculE8AAAAeGVYSWZNTQAqAAAACAAEARoA
BQAAAAEAAAA+ARsABQAAAAEAAABGASgAAwAAAAEAAgAAh2kABAAAAAEAAABOAAAAAAAAAJAAAAAB
      25
       1
-b 76을 주면 25줄, 주지 않으면 1줄이었습니다. 76은 RFC 4648이 말하는 MIME의 줄 길이이고, PEM은 64글자를 씁니다. 그럼 같은 사진을 도구 다섯 가지로 바꾸면 어떨까요?
$ printf 'base64          '; base64 -i photo.jpg | shasum -a 256 | cut -c1-16
printf 'openssl         '; openssl base64 -in photo.jpg | shasum -a 256 | cut -c1-16
printf 'openssl -A      '; openssl base64 -A -in photo.jpg | shasum -a 256 | cut -c1-16
printf 'python3         '; python3 -c "import base64, sys; sys.stdout.write(base64.b64encode(open('photo.jpg', 'rb').read()).decode())" | shasum -a 256 | cut -c1-16
printf 'node            '; node -e "process.stdout.write(require('fs').readFileSync('photo.jpg').toString('base64'))" | shasum -a 256 | cut -c1-16
base64          45f49d6fb7054f5f
openssl         bf5a70646176b1ba
openssl -A      7d251edc6a9b08db
python3         7d251edc6a9b08db
node            7d251edc6a9b08db
openssl -A, 파이썬, Node는 같고 맥 base64와 기본 openssl만 다릅니다. 원인은 줄바꿈이었습니다.
$ tail -c 3 photo.jpg.b64 | xxd && openssl base64 -in photo.jpg -out photo.ossl && head -2 photo.ossl && wc -l < photo.ossl
printf '줄바꿈을 지운 base64  '; tr -d '\n' < photo.jpg.b64 | shasum -a 256 | cut -c1-16
printf '줄바꿈을 지운 openssl '; tr -d '\n' < photo.ossl | shasum -a 256 | cut -c1-16
00000000: 2f5a 0a                                  /Z.
/9j/4AAQSkZJRgABAQAASABIAAD/4QBMRXhpZgAATU0AKgAAAAgAAYdpAAQAAAAB
AAAAGgAAAAAAA6ABAAMAAAABAAEAAKACAAQAAAABAAAEsKADAAQAAAABAAACeQAA
    4092
줄바꿈을 지운 base64  7d251edc6a9b08db
줄바꿈을 지운 openssl 7d251edc6a9b08db
맥 base64는 끝에 줄바꿈(0a) 하나를 붙였고, openssl은 64글자마다 줄을 바꿔 4092줄을 만들었습니다. 줄바꿈을 지우면 둘 다 7d251edc6a9b08db로 같아집니다. RFC 4648은 참조하는 명세가 따로 정하지 않는 한 줄바꿈을 넣으면 안 된다고 하니, 해시나 서명을 비교하는 코드라면 줄바꿈을 지운 뒤 비교하도록 정해 두세요.
압축하면 크기 차이가 줄어들까요?
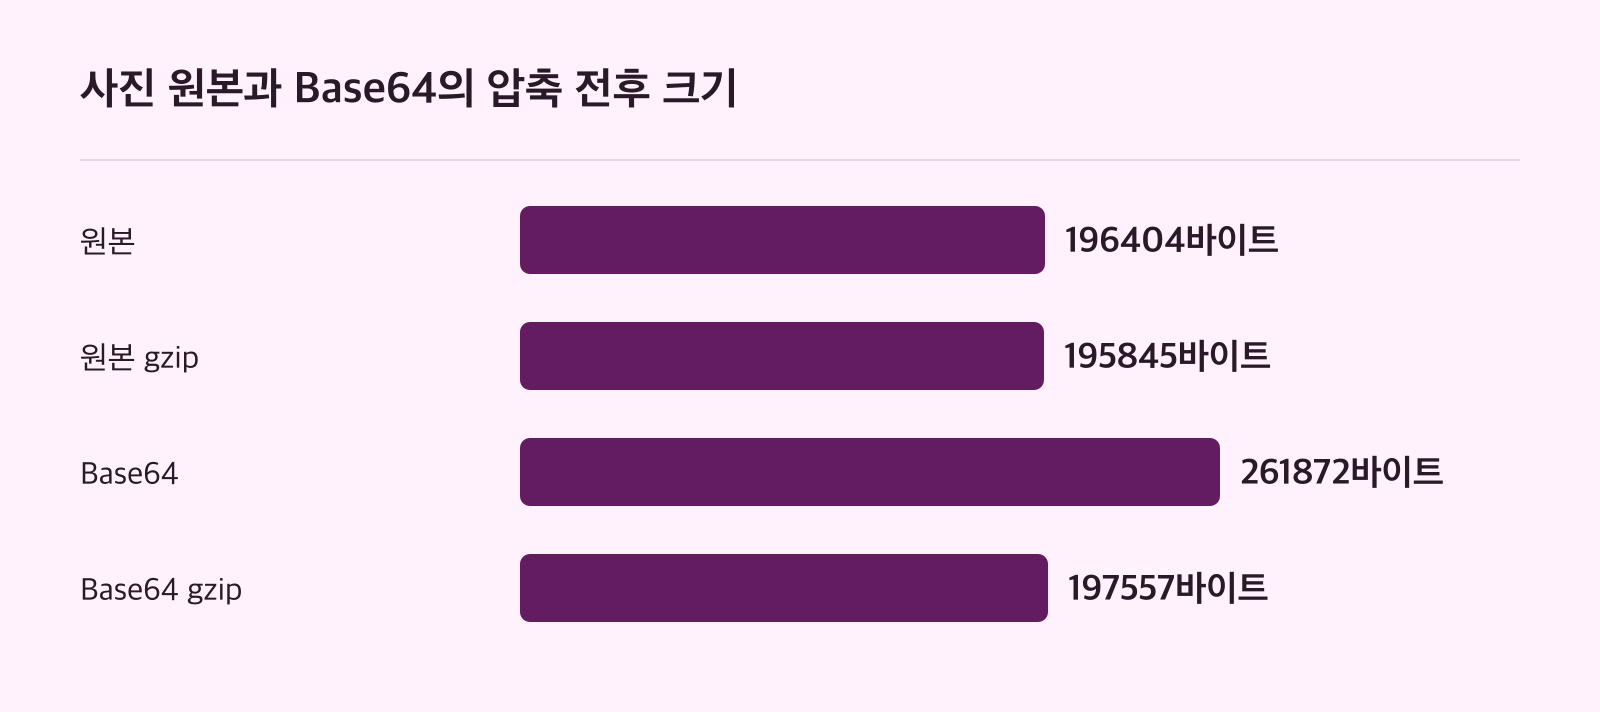
Base64로 늘어난 크기가 압축 뒤에는 어떻게 되는지 gzip -9로 확인했습니다.
$ for f in photo.jpg icon.png; do printf '%s 원본 %s, gzip %s / Base64 %s, gzip %s\n' $f $(wc -c < $f) $(gzip -9 -c $f | wc -c) $(tr -d '\n' < $f.b64 | wc -c) $(tr -d '\n' < $f.b64 | gzip -9 | wc -c); done
photo.jpg 원본 196404, gzip 195845 / Base64 261872, gzip 197557
icon.png 원본 1396, gzip 1182 / Base64 1864, gzip 1272
사진은 원본을 압축하면 195845바이트, Base64를 압축하면 197557바이트였습니다. 아이콘은 1182바이트와 1272바이트였죠. 압축 뒤에는 차이가 크게 줄었지만, 두 파일만 잰 결과라 어떤 파일에서 얼마나 줄어드는지 일반화할 수는 없습니다. 자기 이미지로 같은 명령을 돌려 보는 편이 확실합니다.
이미지를 HTML에 직접 넣어도 화면이 같을까요?
랜딩 페이지나 이메일 템플릿에 사진을 data URI로 넣는 경우가 많습니다. 파일을 참조한 HTML과 Base64로 넣은 HTML을 헤드리스 Chrome으로 찍어 비교했습니다.
$ printf '<img src="photo.jpg" width="600">' > external.html && printf '<img src="data:image/jpeg;base64,%s" width="600">' "$(tr -d '\n' < photo.jpg.b64)" > inline.html && ls -l external.html inline.html | awk '{print $5, $9}'
for p in external inline; do "/Applications/Google Chrome.app/Contents/MacOS/Google Chrome" --headless --disable-gpu --hide-scrollbars --user-data-dir="$PWD/chrome-profile" --window-size=640,360 --screenshot="$PWD/$p.png" "file://$PWD/$p.html" >/dev/null 2>&1; done
shasum -a 256 external.png inline.png | cut -c1-16
33 external.html
261919 inline.html
0f7d97a95b2b36b5
0f7d97a95b2b36b5
두 스크린샷의 해시가 0f7d97a95b2b36b5로 같았으니 화면은 똑같이 그려졌습니다. 대신 HTML 파일은 33바이트와 261919바이트로 차이가 납니다. 화면이 같다고 안심하기보다, HTML 크기가 커져도 괜찮은 곳인지 따져 보는 게 먼저입니다.
디코딩할 때 패딩 오류가 나는 경우
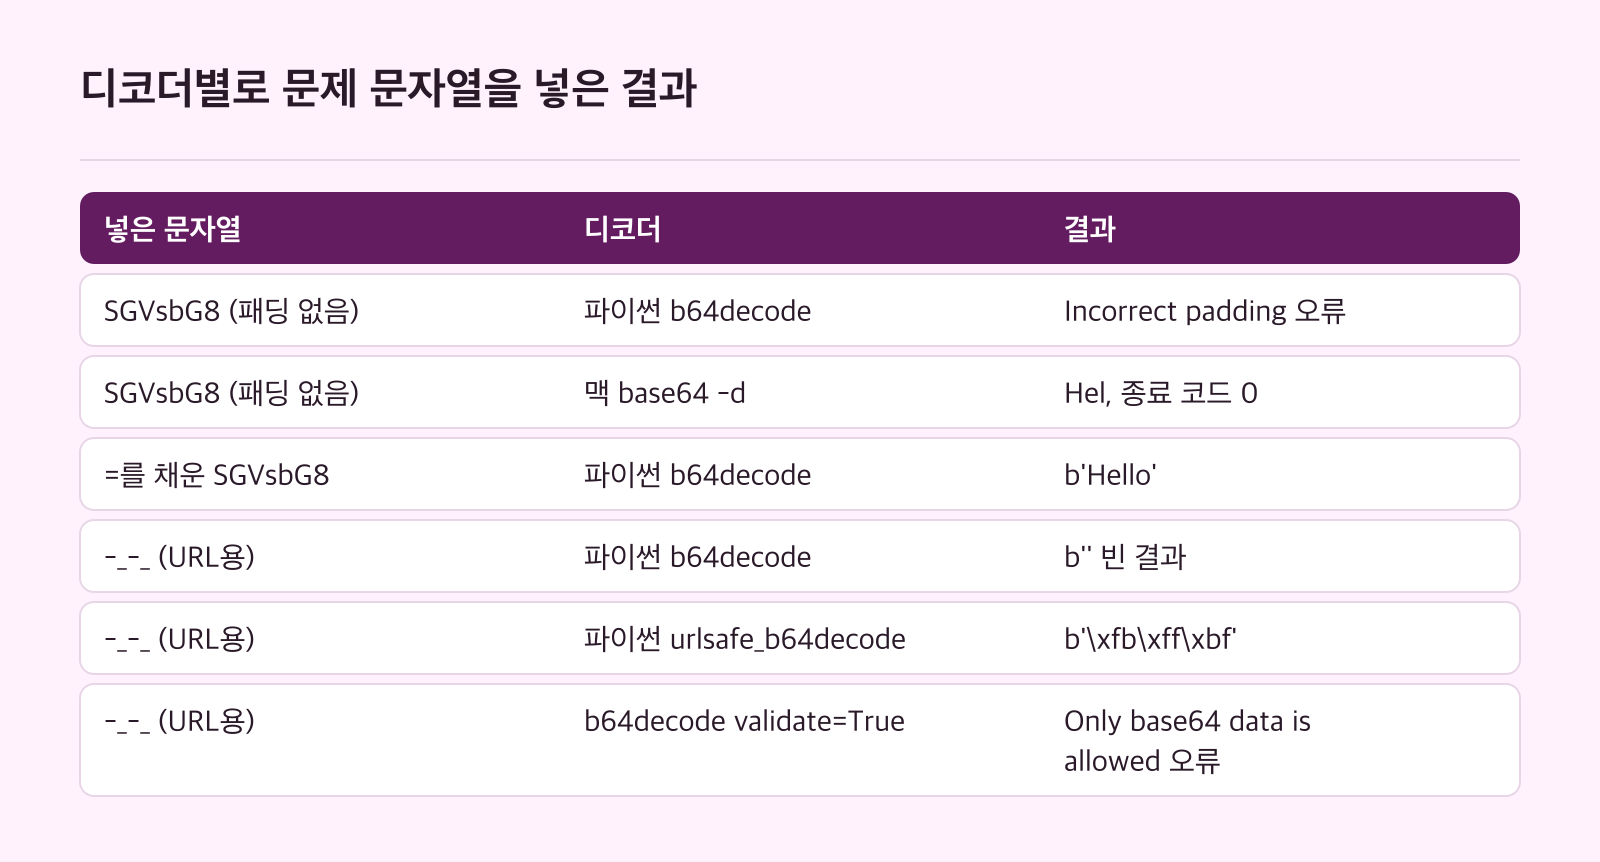
이제 base64 디코딩에서 실제로 부딪히는 오류를 볼 차례입니다. Hello의 결과에서 =를 뺀 SGVsbG8을 파이썬에 넣으면 바로 오류가 납니다.
$ python3 -c "import base64; print(base64.b64decode('SGVsbG8'))"
Traceback (most recent call last):
  File "<string>", line 1, in <module>
    import base64; print(base64.b64decode('SGVsbG8'))
                         ~~~~~~~~~~~~~~~~^^^^^^^^^^^
  File "/opt/homebrew/Cellar/python@3.15/3.15.0_1/Frameworks/Python.framework/Versions/3.15/lib/python3.15/base64.py", line 117, in b64decode
    result = binascii.a2b_base64(s, strict_mode=validate,
                                 padded=padded, ignorechars=ignorechars,
                                 canonical=canonical)
binascii.Error: Incorrect padding
그런데 맥 base64는 다르게 반응합니다. 오류 없이 종료 코드 0으로 끝나지만, 풀린 건 Hel까지였어요.
$ printf 'SGVsbG8' | base64 -d; echo " (종료 코드 $?)"
python3 -c "import base64; s = 'SGVsbG8'; print(base64.b64decode(s + '=' * (-len(s) % 4)))"
Hel (종료 코드 0)
b'Hello'
두 번째 줄처럼 길이가 4의 배수가 되도록 =를 채우면 b'Hello'로 제대로 풀립니다. 셸 스크립트에서 종료 코드만 보고 성공으로 판단하면 잘린 데이터를 놓칠 수 있다는 뜻이죠. RFC 4648도 명세가 따로 정하지 않으면 끝에 패딩을 넣어야 한다고 합니다.
URL용 문자열을 표준 방식으로 풀면
MDN에 따르면 "URL 안전" 변형은 +와 /를 -와 _로 바꾸고 패딩을 생략합니다. 같은 3바이트를 두 방식으로 바꾸고, URL용 문자열을 각 디코더에 넣어 봤습니다.
$ printf '\xfb\xff\xbf' | base64 && python3 -c "import base64; print(base64.urlsafe_b64encode(bytes([0xfb, 0xff, 0xbf])).decode())" && python3 -c "import base64; print(base64.b64decode('-_-_'))" && python3 -c "import base64; print(base64.urlsafe_b64decode('-_-_'))" && python3 -c "import base64
try:
    base64.b64decode('-_-_', validate=True)
except Exception as e:
    print(type(e).__name__ + ':', e)"
+/+/
-_-_
b''
b'\xfb\xff\xbf'
Error: Only base64 data is allowed
파이썬의 기본 b64decode는 -_-_를 오류 없이 빈 바이트(b'')로 돌려줬습니다. 표준 알파벳에 없는 글자를 조용히 버린 것입니다. urlsafe_b64decode를 쓰면 원래 바이트가 나오고, validate=True를 주면 오류로 알려 줍니다. RFC 4648은 명세가 따로 정하지 않으면 알파벳 밖의 글자가 섞인 데이터를 거부해야 한다고 하니, 토큰이나 URL 값을 받는 코드라면 어느 쪽 디코더를 쓰는지부터 확인해 보세요.
자바스크립트에서 한글을 넣으면 나는 오류
프런트엔드 코드를 AI에게 맡기면 btoa가 자주 나옵니다. Node v22.23.1에서 한글을 넣어 봤습니다.
$ node -e "console.log(btoa('Hello'))" && node -e "try { btoa('안녕') } catch (e) { console.log(e.name + ': ' + e.message) }" && node -e "const b = new TextEncoder().encode('안녕'); console.log(btoa(String.fromCharCode(...b)))" && node -e "console.log(Buffer.from('안녕').toString('base64'))" && printf '안녕' | base64
SGVsbG8=
InvalidCharacterError: Invalid character
7JWI64WV
7JWI64WV
7JWI64WVbtoa('안녕')은 InvalidCharacterError를 냈습니다. MDN은 브라우저의 btoa도 코드 포인트가 0xff를 넘으면 예외를 낸다고 설명하고, 먼저 TextEncoder로 UTF-8 바이트를 만들라고 권합니다. 그렇게 고친 결과와 Node의 Buffer, 맥 base64의 출력이 모두 7JWI64WV로 같았습니다.
JSON에 넣을 때 줄바꿈 막기
앞에서 본 openssl의 64글자 줄바꿈은 JSON에 넣어도 사라지지 않습니다. jq는 줄바꿈을 이스케이프하므로 유효한 JSON이지만, 문자열 값에는 줄바꿈이 남습니다. 받는 API가 줄바꿈 없는 한 줄짜리 Base64를 요구한다면 -A를 붙여 인코딩하는 편이 좋습니다. 81바이트짜리 파일로 확인했습니다.
$ seq 1 30 > note.txt && wc -c < note.txt && jq -n --arg data "$(openssl base64 -in note.txt)" '{data: $data}' && jq -n --arg data "$(openssl base64 -A -in note.txt)" '{data: $data}'
      81
{
  "data": "MQoyCjMKNAo1CjYKNwo4CjkKMTAKMTEKMTIKMTMKMTQKMTUKMTYKMTcKMTgKMTkK\nMjAKMjEKMjIKMjMKMjQKMjUKMjYKMjcKMjgKMjkKMzAK"
}
{
  "data": "MQoyCjMKNAo1CjYKNwo4CjkKMTAKMTEKMTIKMTMKMTQKMTUKMTYKMTcKMTgKMTkKMjAKMjEKMjIKMjMKMjQKMjUKMjYKMjcKMjgKMjkKMzAK"
}
기본값으로는 값 중간에 \n이 들어갔고, -A를 주면 한 줄로 들어갔습니다. API 요청 본문이나 환경 변수에 Base64를 넣는 스크립트라면 -A를 붙였는지 확인해 보세요.
AI 코딩 도구에게 변환 명령을 맡길 때
마지막으로 Claude Code 2.1.309(--model opus)에게 data URI 명령을 한 줄로 만들게 하고, 그 명령을 그대로 실행했습니다. 명령 생성부터 실행·확인까지 한 단계 전체에 6.3초가 걸렸습니다.
$ claude --model opus -p "맥 터미널에서 icon.png 파일을 HTML img 태그의 src에 넣을 수 있는 data URI 문자열(data:image/png;base64,...)로 바꿔 icon.txt에 저장하는 명령 한 줄만 출력해. 설명이나 코드 블록 표시는 붙이지 마." < /dev/null > cmd.txt && cat cmd.txt && sh cmd.txt && head -c 60 icon.txt && echo && wc -c < icon.txt
printf 'data:image/png;base64,%s' "$(base64 -i icon.png)" > icon.txt
data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAACAAAAAgCAYAAA
    1886
맥 base64의 -i 옵션을 쓴 명령이 나왔고, 결과 파일은 data:image/png;base64,로 시작하는 1886바이트였습니다. AI가 만든 명령은 이렇게 head -c와 wc -c로 앞부분과 크기를 바로 확인해 두면, 줄바꿈이나 잘림 문제를 일찍 잡을 수 있습니다.
측정 조건과 한계
- 환경: darwin arm64, Node.js v22.23.1, Homebrew의 파이썬 3.15, Claude Code 2.1.309
- 방식: 새 임시 폴더에서 각 명령을 한 번씩 실행
- 크기:
wc -c로 잰 바이트 수, Base64 크기는 줄바꿈을 뺀 값 - 이미지: 맥에 들어 있는 아이콘과 기본 배경화면 사진을 줄인 파일
크기와 비율은 이 파일들로 한 번 잰 값이라 다른 파일에서는 달라질 수 있습니다. 리눅스의 base64 같은 다른 도구는 이번에 실행하지 않았으니, 서버나 CI에서 돌릴 스크립트라면 그 환경에서 같은 명령으로 다시 확인해 보세요.
참고 자료
- Base64 developer.mozilla.org
- datatracker.ietf.org/doc/html/rfc4648 datatracker.ietf.org
- man.freebsd.org/cgi/man.cgi?query=base64 man.freebsd.org