코덱스(Codex) 사용량, 같은 버그 수정을 모델 3개에 맡겨 보니
같은 장바구니 버그 수정을 GPT-6 Luna, GPT-6.1 Sol, GPT-6 Astra에 3번씩 맡겨 Codex 사용량을 비교했습니다. 셋 다 성공했지만 크레딧 중앙값은 0.033, 0.54, 3.37이었어요. 코덱스 사용량을 확인하는 곳과 한도에 닿았을 때의 선택지도 함께 정리했습니다.
Finn · · 수정
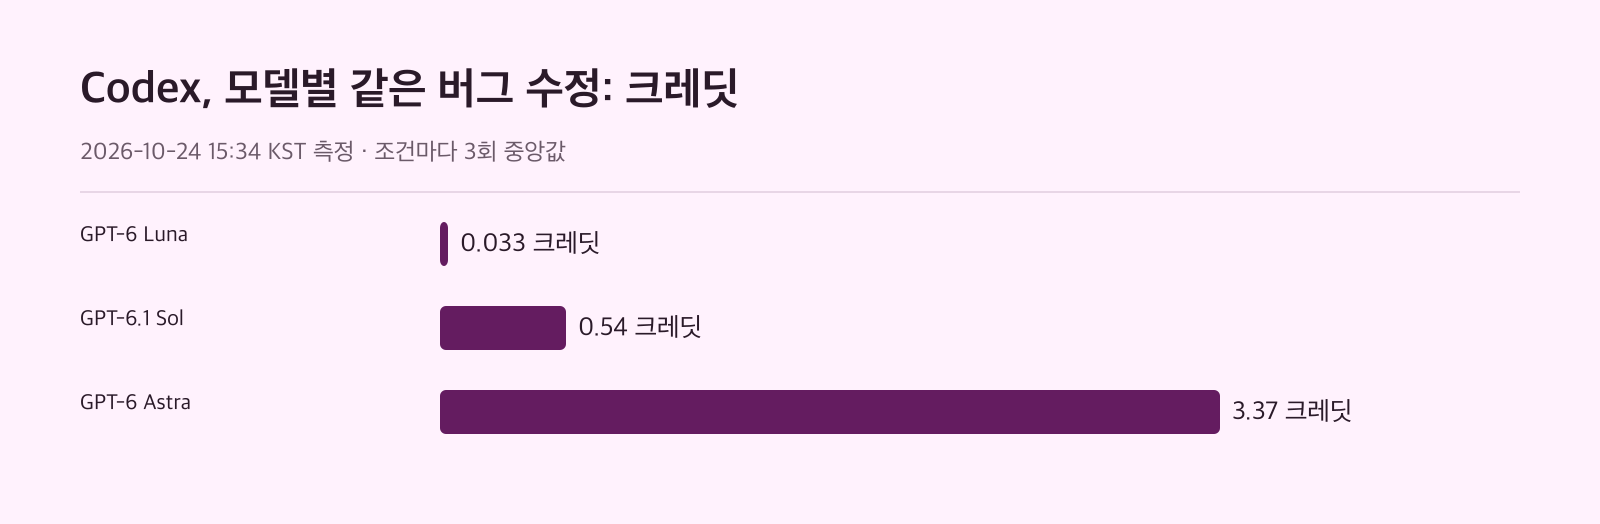
장바구니 금액 계산 버그 하나를 Codex CLI에 맡겼더니 GPT-6 Luna는 0.033크레딧, GPT-6.1 Sol은 0.54크레딧, GPT-6 Astra는 3.37크레딧을 썼습니다(3회 중앙값, 공식 단가로 계산). 세 모델 모두 3/3으로 테스트를 통과시켰는데도 크레딧은 Luna보다 16.5배, 102.2배 많이 나왔죠. 코덱스로 혼자 제품을 만들다가 Codex 사용량이 생각보다 빨리 줄어든다면 이 숫자부터 확인해 보세요.
세 모델이 같은 작업에 쓴 양은?
결과부터 보겠습니다. 아래 표는 같은 요청을 모델만 바꿔 3번씩 실행한 뒤 낸 중앙값입니다.
| 모델 | 성공 | 걸린 시간 | 입력 토큰 | 캐시 읽기 | 출력 토큰 | 추론 토큰 | 도구 호출 | 크레딧 |
|---|---|---|---|---|---|---|---|---|
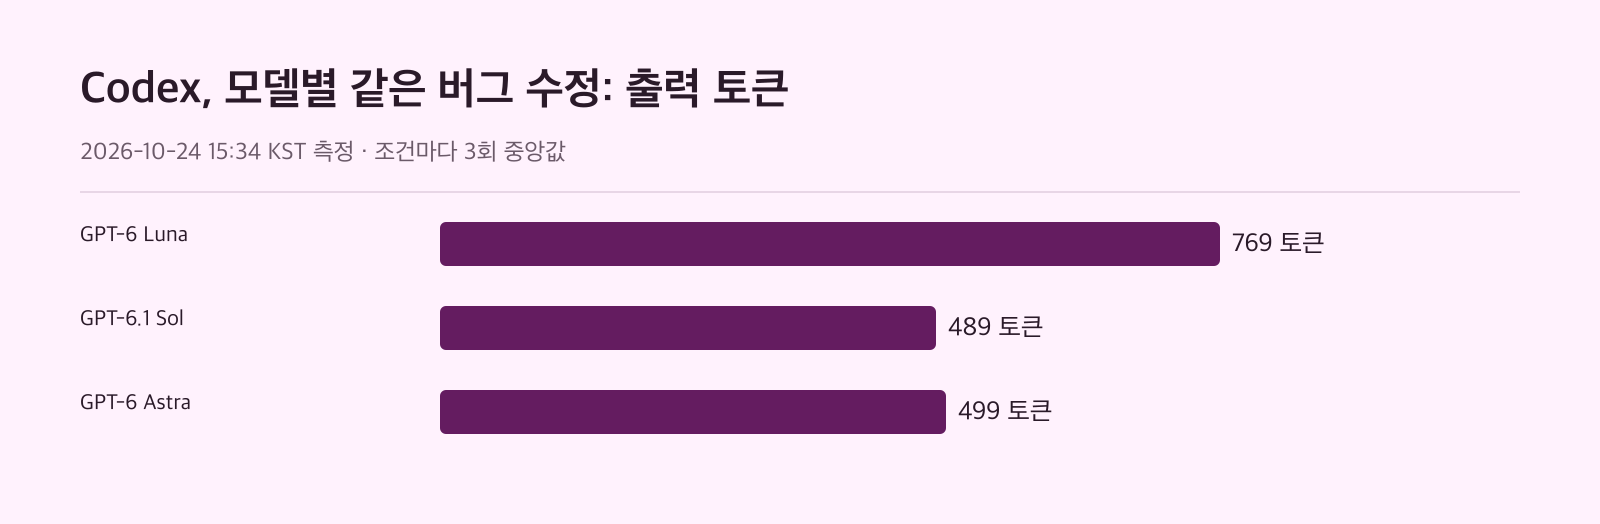
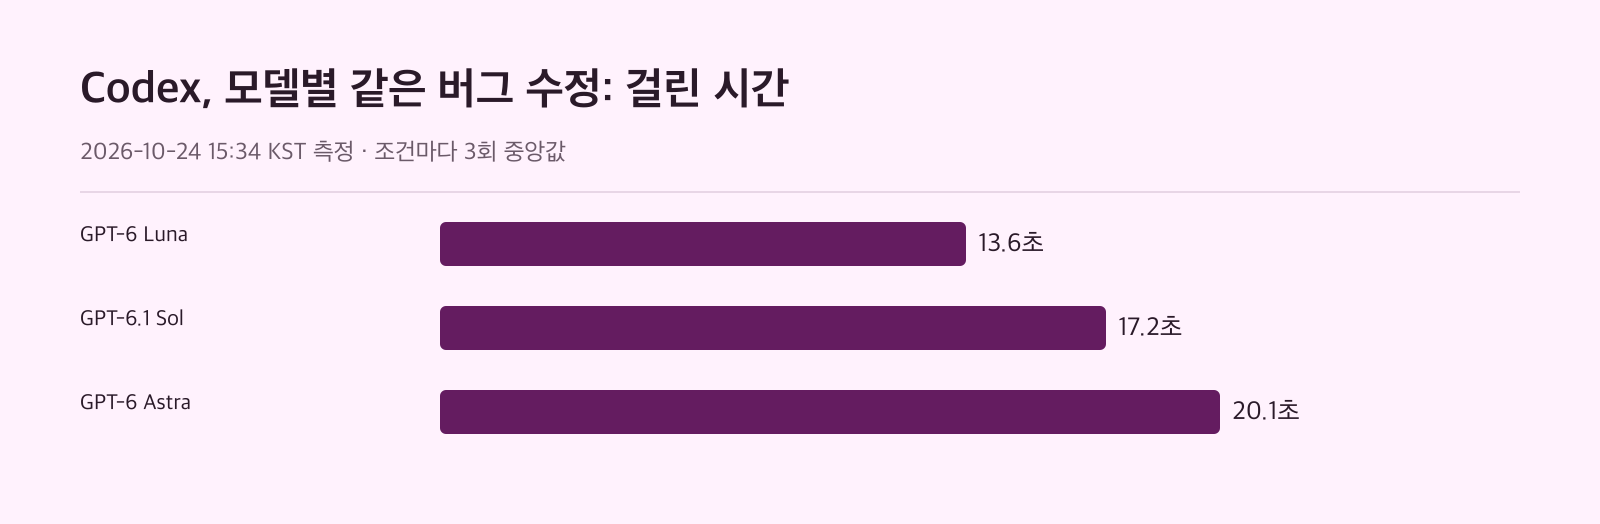
| GPT-6 Luna | 3/3 | 13.6초 | 56,563 | 50,176 | 769 | 110 | 3 | 0.033 |
| GPT-6.1 Sol | 3/3 | 17.2초 | 58,555 | 52,864 | 489 | 0 | 4 | 0.54 |
| GPT-6 Astra | 3/3 | 20.1초 | 58,261 | 52,352 | 499 | 0 | 4 | 3.37 |
회차별로 봐도 순서는 바뀌지 않았습니다. Luna는 0.0330.039, Sol은 0.530.68, Astra는 3.18~3.38크레딧 사이였어요. 테스트로 바로 확인되는 작은 버그라면, 이 측정에서는 가장 싼 모델도 결과가 같았다는 뜻입니다.
그렇다면 이 숫자는 어떤 조건에서 나왔을까요? 같은 결과를 내 프로젝트에 그대로 옮겨도 되는지 판단하려면 측정 방식부터 알아야 합니다.
함께 읽을 글
어떤 작업으로 쟀나요?
작업 폴더에는 금액 계산 파일 src/cart.js와 테스트 6개가 든 test/cart.test.js가 있습니다. 테스트에는 정률 쿠폰의 원 단위 버림, 5만 원부터 배송비 무료, 빈 장바구니 0원 같은 규칙이 들어 있어요. 요청은 세 모델 모두 같았습니다.
test/cart.test.js의 테스트가 모두 통과하도록 src/cart.js를 고쳐 주세요. 테스트 파일은 고치지 마세요. 고친 뒤 node --test로 확인해 주세요.
예를 들어 고쳐야 할 함수 하나는 이렇게 생겼습니다.
export function shippingFee(amount) {
  return amount > FREE_SHIPPING_FROM ? 0 : SHIPPING_FEE;
}
실행 조건은 다음과 같습니다.
codex-cli 0.163.0-alpha.11.2, darwin arm64, Node.js v22.23.1codex exec --json으로 비대화형 실행, 조건마다 새 임시 폴더에 작업 폴더 복사--ignore-user-config,--ignore-rules,--disable plugins,--disable apps로 사용자 설정·규칙·플러그인·앱 연결을 끄고, 사용자 스킬도 끔- 샌드박스는 작업 폴더에만 쓸 수 있는
-s workspace-write - 기본 추론 강도, Standard 속도, 모델만 바꿈
- 성공 기준: 실행 뒤
node --test가 통과하고 테스트 파일이 그대로일 때
크레딧 차이는 어디서 생겼나요?
크레딧은 공식 단가로 이렇게 계산했습니다. (입력 토큰 − 캐시 읽기)×입력 단가에 캐시 읽기×캐시 입력 단가, 출력 토큰×출력 단가를 더한 값이죠. 단가는 Codex 가격 문서의 Standard 속도 기준입니다.
| 100만 토큰당 크레딧 | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
| GPT-6 Astra | 250 | 25 | 1,250 |
| GPT-6.1 Sol | 50 | 2.5 | 250 |
| GPT-6 Luna | 2.5 | 0.25 | 12.5 |
입력 토큰은 세 모델이 Luna 대비 1.0배로 거의 같았습니다. 그래서 입력량은 비슷했지만, 크레딧 차이는 대부분 모델별 단가 차이에서 나옵니다. 그런데 출력 토큰은 오히려 Luna가 769로 가장 많았고, Sol과 Astra는 Luna의 0.6배였어요. 추론 토큰도 Luna에만 110이 잡혔습니다. 왜 그런지는 이 측정만으로는 가를 수 없으니, 궁금하다면 회차별 이벤트 기록의 출력을 직접 비교해 보세요.
걸린 시간은 Luna 13.6초, Sol 17.2초, Astra 20.1초로 Luna 대비 1.3배, 1.5배였습니다. 도구 호출도 Luna가 3번, 나머지가 4번으로 달랐지만, 이것이 시간 차이를 만들었는지는 이 측정으로 알 수 없어요. 가격 문서도 비슷해 보이는 작업이 모델·맥락·추론·도구 사용·캐시에 따라 다른 양을 쓸 수 있다고 설명합니다.
측정 계정의 한도는 얼마나 줄었나요?
측정 계정은 Pro 플랜이었습니다. 측정 전과 후 모두 주간(7일) 창 19% 사용, 두 번째 창 없음으로 기록됐어요. 9번 실행하는 동안 주간 사용률이 1% 단위로는 바뀌지 않았다는 뜻입니다.
다만 이 값은 Codex가 남긴 세션 기록에서 읽은 것이라 1% 단위로만 보입니다. 같은 계정의 다른 사용도 함께 잡히고요. 문서도 크레딧 가격만으로 구독에 포함된 사용량이 정해지지 않는다고 밝히니, 크레딧 숫자를 한도 비율로 바로 바꿔 읽지는 마세요.
Codex 사용량 확인은 어디서 하나요?
현재 한도는 사용량 대시보드에서 볼 수 있습니다. Codex CLI 세션을 쓰는 중이라면 /status로 남은 한도를 바로 확인할 수 있어요.
문서는 대시보드를 1~2주마다 확인해 사용 속도와 남은 양을 파악하라고 권합니다. 사용량이 예상보다 많다면 더 작은 모델이나 더 좁은 작업 범위로도 쓸 만한 결과가 나오는지 따져 보라고 하죠. 위 측정이 바로 그런 비교의 예입니다.
플랜별 Codex 한도는 어떻게 다른가요?
Plus와 Standard Business는 5시간마다 보낼 수 있는 로컬 메시지 수를 다음처럼 추정합니다. 고정된 한도가 아니라 추정치라서, 실제 한도와 초기화 시각은 대시보드에서 확인해야 해요.
| 모델 | Plus (5시간당 로컬 메시지) | Standard Business |
|---|---|---|
| GPT-6 Astra | 5-45 | 5-45 |
| GPT-6.1 Sol | 15-160 | 15-160 |
| GPT-6 Luna | 350-3,000 | 350-3,000 |
Pro 플랜은 현재 5시간 한도가 없습니다. 어느 플랜이든 로컬 메시지와 클라우드 채팅은 플랜 사용량을 함께 쓰고, 주간 한도도 붙을 수 있습니다. 클라우드 작업은 로컬 메시지보다 더 많이 쓸 수 있습니다. 유연 요금(flexible pricing)을 쓰는 Enterprise/Edu는 고정 한도 없이 크레딧에 따라 쓰고, 유연 요금이 아닌 Enterprise/Edu는 대부분 기능에서 Plus와 같은 좌석당 한도를 씁니다.
워크스페이스 플랜이라면 관리자가 설정하는 사용 한도와 지출 관리도 함께 보세요. 이 관리 기능은 일부 Codex 활동에만 적용되고, API 플랫폼 결제는 다루지 않습니다.
한도에 닿으면 어떤 선택지가 있나요?
한도에 닿아도 진행 중인 턴은 계속됩니다. 그 뒤에 고를 수 있는 선택지는 플랜에 따라 다르니, 아래 플랜별 선택지 중 자기 플랜에 맞는 것을 고르면 됩니다.
- 대시보드나 CLI 세션의
/status로 남은 한도와 초기화 시각을 확인합니다. - 진행 중인 턴에서 한도에 닿으면, 공정 사용 범위 안에서 그 턴은 계속 진행됩니다.
- Plus·Pro 사용자는 플랜을 올리지 않고 추가 크레딧을 사서 계속 작업할 수 있습니다.
- 유연 요금을 쓰는 Business·Edu·Enterprise는 워크스페이스 크레딧을 추가로 살 수 있습니다.
- 모든 사용자는 API 키로 로컬 채팅을 더 돌릴 수 있고, 이때는 표준 API 요금이 붙습니다.
작업마다 모델은 어떻게 고를까요?
이 측정에서 얻을 수 있는 기준은 분명합니다. 테스트가 이미 있고 범위가 파일 하나인 버그라면 Luna로 먼저 맡겨 보는 편이 합리적이에요. 성공률은 같았고, 크레딧은 0.033으로 가장 적었으며, 시간도 13.6초로 가장 짧았습니다.
그럼 Sol이나 Astra는 쓸 이유가 없을까요? 이 측정은 작은 작업 하나만 다뤘기 때문에, 큰 작업에서의 차이는 알 수 없습니다. 그래서 이렇게 나눠 보길 권합니다.
- 테스트로 바로 검증되는 작은 수정: Luna부터 시도하고, 실패할 때만 상위 모델로 다시 실행
- 같은 일을 여러 번 반복하는 스크립트 작업: 회당 크레딧 차이가 쌓이니 모델별로 한두 번 직접 재 보기
- 평소 MCP 서버나 큰
AGENTS.md를 쓰는 경우: 이 측정은 사용자 설정(config.toml)·규칙 파일을 끈 상태였으니, 평소 환경에서는 문서 권고대로 필요 없는 MCP 서버와AGENTS.md내용을 줄여 비교해 보기
측정 조건과 한계
- 작은 버그 수정 하나를 조건마다 3번만 실행한 결과입니다. 큰 작업이나 클라우드 작업에서는 다를 수 있어요.
- 사용자 설정·규칙·플러그인·앱 연결·사용자 스킬을 끈 상태였습니다. 평소 환경에서는 입력 토큰이 달라질 수 있습니다.
- Standard 속도로만 쟀습니다. 문서 기준으로 Fast 모드는 구독 포함 사용량을 2.5x, 구매 크레딧을 2x 쓰고, GPT-6 Astra와 GPT-6.1 Sol의 Ultrafast는 두 모델 모두 구독 포함 사용량을 8x, 구매 크레딧과 Enterprise 종량제 사용량을 6x 씁니다.
- 크레딧은 공식 단가로 계산한 값이며, 실제 구독 한도 차감과 같다는 보장은 없습니다.
- 한도 사용률은 1% 단위이고, 같은 계정의 다른 사용도 함께 잡힙니다.
참고 자료
- Pricing learn.chatgpt.com
- ChatGPT usage limits and spend controls learn.chatgpt.com