재귀함수 이해하기, 파이썬 팩토리얼·피보나치·재귀 한도 직접 해 보니
재귀함수를 파이썬으로 직접 실행해 보니 두 갈래로 부르는 피보나치는 fib(25)에서 호출이 242,785번이었고 캐시를 붙이자 실제 계산이 26번으로 줄었습니다. 기본 재귀 한도 1000과 오류, 반복문 전환, Claude Code가 쓴 코드까지 살펴봅니다.
Finn ·
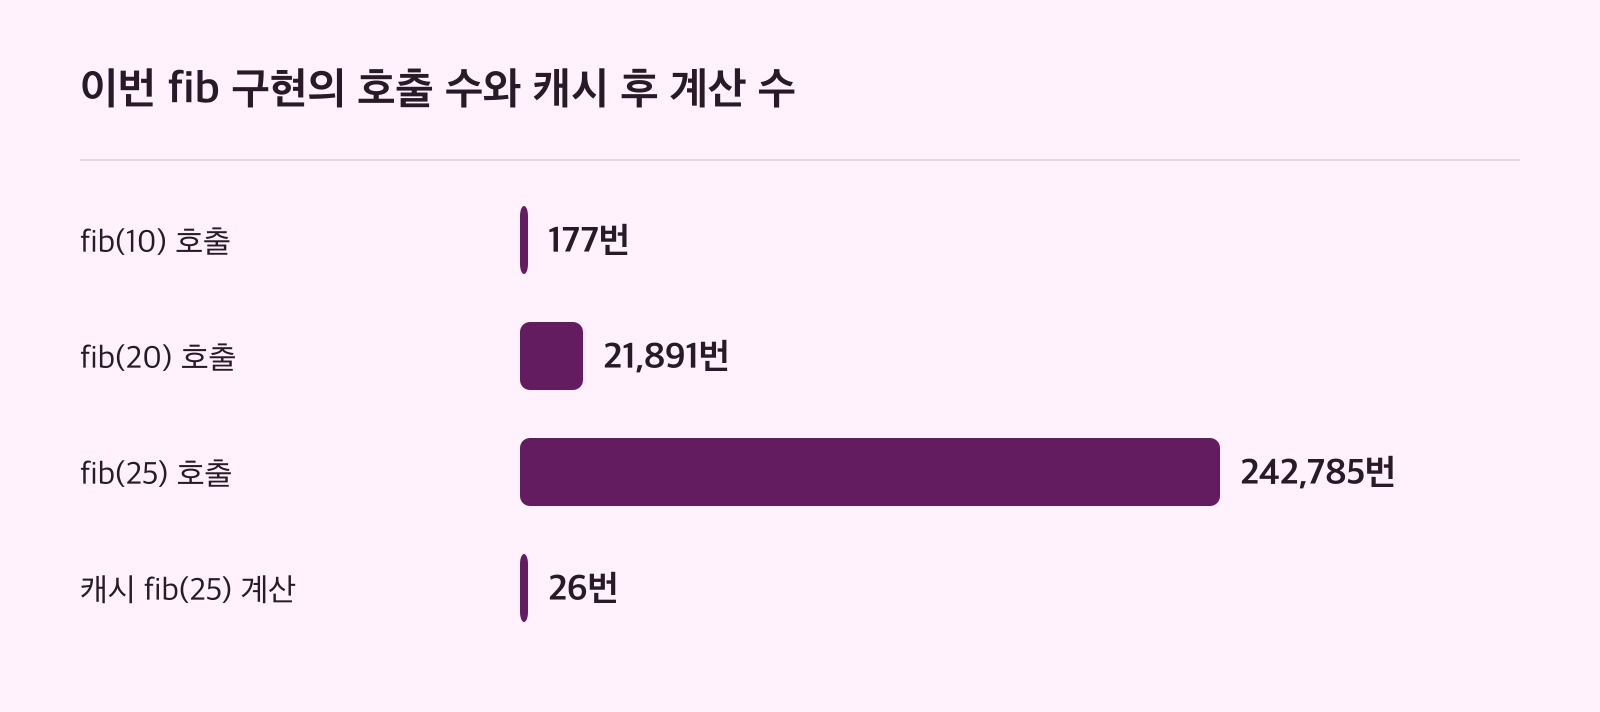
두 갈래로 자기 자신을 부르는 피보나치 재귀함수로 fib(25)를 구해 보면, 이번 실행에서는 함수 호출이 242,785번 일어났습니다. 같은 함수에 functools.lru_cache를 붙이자 실제 계산은 26번으로 줄었고, 파이썬의 기본 재귀 한도는 1000이었습니다. AI 코딩 도구가 짜 준 재귀 코드를 그대로 붙여 넣기 전에 이 숫자들이 어디서 나오는지 알아 두면, 리뷰할 때 무엇을 봐야 할지가 분명해집니다.
재귀함수란 무엇일까요?
재귀함수는 자기 자신을 더 작은 입력으로 다시 부르는 함수입니다. 그리고 어딘가에서 멈추게 하는 종료 조건이 꼭 있어야 하죠. 가장 작은 예는 카운트다운입니다.
$ python3 - <<'PY'
def countdown(n):
    if n == 0:  # 종료 조건
        print("발사!")
        return
    print(n)
    countdown(n - 1)  # 자기 자신을 다시 부른다
countdown(3)
PY
3
2
1
발사!countdown(3)은 3을 찍고 countdown(2)를 부르고, 이렇게 입력이 하나씩 줄다가 n == 0에서 "발사!"를 찍고 돌아옵니다. 그런데 이 if 줄을 빼면 어떻게 될까요? 뒤에서 보겠지만 파이썬은 기본 한도 1000에 걸려 RecursionError를 냅니다.
이번 실행의 결론을 먼저 말하면 이렇습니다. 그냥 재귀로 짠 피보나치는 n이 커질수록 호출 수가 빠르게 늘었고, 캐시를 붙이면 실제 계산 수가 크게 줄었습니다. 종료 조건이 없거나 너무 깊이 들어가는 재귀는 한도에서 멈췄습니다.
함께 읽을 글
팩토리얼은 어떤 순서로 쌓였다가 돌아올까요?
재귀가 헷갈리는 이유는 대개 "언제 돌아오느냐"입니다. 그래서 호출 깊이만큼 들여쓰기를 넣어 찍어 보면 흐름이 눈에 보입니다.
$ python3 - <<'PY'
def factorial(n, depth=0):
    print("  " * depth + f"factorial({n}) 호출")
    if n <= 1:
        print("  " * depth + "→ 1 반환")
        return 1
    result = n * factorial(n - 1, depth + 1)
    print("  " * depth + f"→ {result} 반환")
    return result
print("결과:", factorial(4))
PY
factorial(4) 호출
  factorial(3) 호출
    factorial(2) 호출
      factorial(1) 호출
      → 1 반환
    → 2 반환
  → 6 반환
→ 24 반환
결과: 24
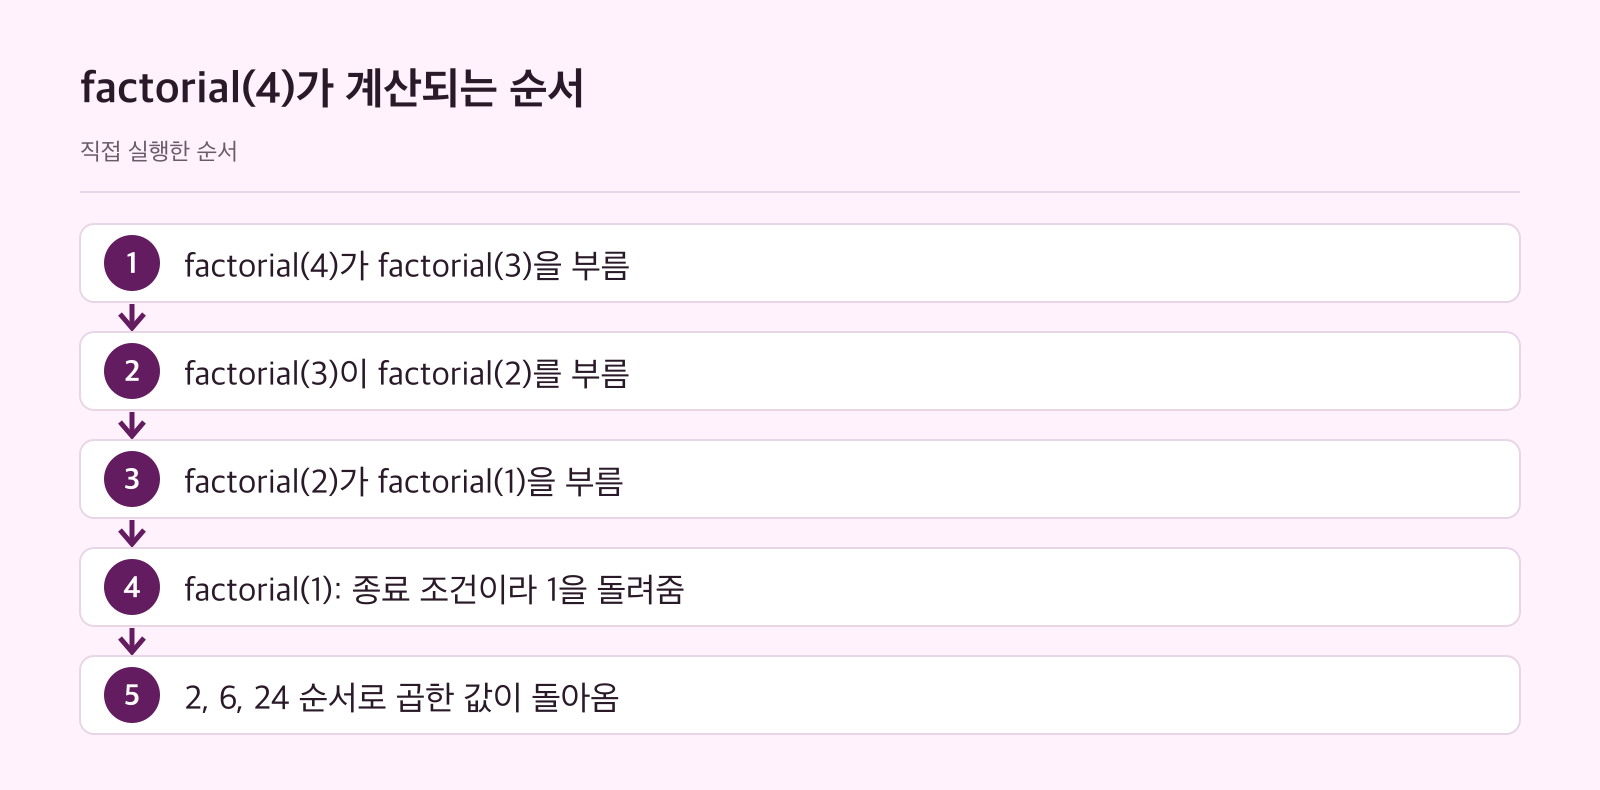
호출은 바깥에서 안쪽으로 쌓이고, factorial(1)이 종료 조건에서 1을 돌려준 뒤에야 곱셈이 안쪽부터 차례로 끝납니다. 즉 바깥 호출은 안쪽 결과가 올 때까지 기다리고 있는 셈이죠.
피보나치 호출 수는 얼마나 늘어날까요?
팩토리얼은 한 갈래로만 내려가지만, 피보나치는 fib(n - 1)과 fib(n - 2) 두 갈래로 자기를 부릅니다. 이번에는 호출 수를 세는 변수를 두고, 캐시를 붙인 버전과 나란히 실행했습니다.
$ python3 - <<'PY'
import time
from functools import lru_cache
calls = 0
def fib(n):
    global calls
    calls += 1
    return n if n < 2 else fib(n - 1) + fib(n - 2)
for n in (10, 20, 25):
    calls = 0
    t = time.perf_counter()
    v = fib(n)
    print(f"fib({n}) = {v}, 호출 {calls:,}번, {time.perf_counter() - t:.3f}초")
@lru_cache(maxsize=None)
def fib2(n):
    return n if n < 2 else fib2(n - 1) + fib2(n - 2)
t = time.perf_counter()
v = fib2(25)
print(f"lru_cache fib(25) = {v}, 실제 계산 {fib2.cache_info().misses}번, {time.perf_counter() - t:.6f}초")
PY
fib(10) = 55, 호출 177번, 0.000초
fib(20) = 6765, 호출 21,891번, 0.001초
fib(25) = 75025, 호출 242,785번, 0.009초
lru_cache fib(25) = 75025, 실제 계산 26번, 0.000010초
이 수치는 두 갈래로 자기를 부르는 이번 fib 구현의 호출 수입니다. 같은 n이 여러 번 다시 불릴 수 있는 구조라서, functools 공식 문서도 피보나치를 캐시 예시로 듭니다. 걸린 시간은 0.009초와 0.000010초였지만 한 번만 잰 값이라, 차이의 크기를 일반화하기는 어렵습니다.
그럼 캐시는 정확히 무엇을 해 줄까요? 문서에 따르면 lru_cache는 최근 호출 결과를 저장해 두는 데코레이터이고, maxsize를 None으로 두면 LRU 기능이 꺼지고 캐시가 제한 없이 커질 수 있습니다. functools.cache는 lru_cache(maxsize=None)과 같은 것을 돌려줍니다. 위 출력의 "실제 계산 26번"은 cache_info()가 돌려주는 값 중 misses, 곧 캐시에 없어서 실제로 계산한 횟수입니다.
서비스 코드에 붙일 때는 문서의 주의점도 같이 봐 두세요.
- 결과를 딕셔너리에 저장하므로 인자는 해시 가능해야 합니다.
- 웹 서버처럼 오래 도는 프로세스에서는 크기 제한이 캐시가 끝없이 커지는 것을 막아 줍니다.
- 부작용이 있는 함수나
time(),random()같은 비순수 함수는 캐시해도 의미가 없습니다.
재귀 한도는 얼마이고, 넘으면 어떻게 될까요?
이제 종료 조건이 없는 함수와 너무 깊은 재귀를 일부러 돌려 봤습니다. 한도 값은 sys 모듈의 sys.getrecursionlimit()로 읽었습니다.
$ python3 - <<'PY'
import sys
print("기본 재귀 한도:", sys.getrecursionlimit())
def forever(n):
    return forever(n + 1)  # 종료 조건이 없다
try:
    forever(0)
except RecursionError as e:
    print("RecursionError:", e)
def deep(n):
    return 0 if n == 0 else 1 + deep(n - 1)
print("깊이 900:", deep(900))
try:
    deep(5000)
except RecursionError as e:
    print("깊이 5000:", type(e).__name__)
sys.setrecursionlimit(10000)
print("한도를 10000으로 올린 뒤 깊이 5000:", deep(5000))
PY
기본 재귀 한도: 1000
RecursionError: maximum recursion depth exceeded
깊이 900: 900
깊이 5000: RecursionError
한도를 10000으로 올린 뒤 깊이 5000: 5000
종료 조건이 없는 forever는 "maximum recursion depth exceeded" 메시지와 함께 멈췄습니다. 제대로 끝나는 deep도 깊이 900은 통과했지만 깊이 5000에서는 같은 오류가 났죠. sys.setrecursionlimit(10000)으로 한도를 올린 뒤에는 깊이 5000이 끝까지 돌았습니다.
그래서 깊이를 미리 알 수 없는 데이터를 재귀로 처리한다면, 한도에 닿을 수 있다는 전제로 짜는 편이 낫다고 봅니다. 한도를 올리는 것이 여러분 환경에서 괜찮은지는 이번 기록만으로 판단할 수 없으니, 올리기 전에 sys 문서를 확인해 보세요.
반복문으로 바꾸면 어떻게 될까요?
이럴 때 가장 확실한 대안은 같은 계산을 반복문으로 쓰는 것입니다. 자기 자신을 부르지 않으니 재귀 한도와 상관이 없습니다.
$ python3 - <<'PY'
def factorial_loop(n):
    result = 1
    for i in range(2, n + 1):
        result *= i
    return result
def fib_loop(n):
    a, b = 0, 1
    for _ in range(n):
        a, b = b, a + b
    return a
print("factorial_loop(10):", factorial_loop(10))
print("fib_loop(25):", fib_loop(25))
print("fib_loop(90):", fib_loop(90))
PY
factorial_loop(10): 3628800
fib_loop(25): 75025
fib_loop(90): 2880067194370816120fib_loop(25)는 재귀 버전과 같은 75025를 냈고, fib_loop(90)도 바로 결과가 나왔습니다. 다만 반복문 버전의 시간은 따로 재지 않았으니, 속도 비교는 직접 돌려서 확인해 보세요.
폴더 속 파일은 재귀로 어떻게 셀까요?
재귀가 반복문보다 자연스러운 곳도 있습니다. 폴더 안에 폴더가 몇 겹 있을지 모르는 경우가 대표적이죠.
$ mkdir -p notes/2026/10 notes/2026/11 notes/drafts && touch notes/a.md notes/2026/10/b.md notes/2026/10/c.md notes/2026/11/d.md notes/drafts/e.md && python3 - <<'PY'
import os
def count_files(path, depth=0):
    total = 0
    for entry in sorted(os.scandir(path), key=lambda e: e.name):
        if entry.is_dir():
            print("  " * depth + entry.name + "/")
            total += count_files(entry.path, depth + 1)
        else:
            print("  " * depth + entry.name)
            total += 1
    return total
print("파일 수:", count_files("notes"))
PY
2026/
  10/
    b.md
    c.md
  11/
    d.md
a.md
drafts/
  e.md
파일 수: 5
폴더를 만나면 그 안으로 자기 자신을 다시 부르고, 파일을 만나면 1을 더합니다. 여기서 종료 조건은 따로 쓴 if가 아니라 "하위 폴더가 더 없을 때"이고, 그때 반복문이 끝나면서 합계가 위로 돌아갑니다.
AI 코딩 도구가 짠 재귀 코드는 어떻게 볼까요?
마지막으로 Claude Code에게 중첩 리스트를 한 줄로 펼치는 재귀함수를 쓰게 하고 바로 실행했습니다. 아래는 한 번 받아 본 결과 그대로이고, 명령이 끝나기까지 6.0초가 걸렸습니다.
$ claude --model opus -p "중첩된 파이썬 리스트를 한 줄로 펼치는 재귀함수 flatten을 쓰고, 그 아래에 print(flatten([1, [2, [3, [4, 5]], 6], [[7]]]))를 넣은 코드만 출력해. 설명이나 코드 블록 표시는 붙이지 마." > flatten.py && cat flatten.py && python3 flatten.py
def flatten(lst):
    result = []
    for item in lst:
        if isinstance(item, list):
            result.extend(flatten(item))
        else:
            result.append(item)
    return result


print(flatten([1, [2, [3, [4, 5]], 6], [[7]]]))
[1, 2, 3, 4, 5, 6, 7]
이 코드도 폴더 예와 같은 모양입니다. 리스트를 만나면 자기를 다시 부르고, 리스트가 아닌 값은 결과에 넣고 끝냅니다. AI가 짠 재귀 코드를 리뷰할 때는 이 세 가지를 먼저 보면 좋습니다.
- 더 이상 부르지 않는 경우(종료 조건)가 분명히 있는지
- 다시 부를 때 입력이 실제로 작아지는지
- 입력이 얼마나 깊어질 수 있는지, 기본 한도 1000에 닿을 수 있는지
측정 조건과 한계
모든 실행은 맥 한 대(darwin arm64)의 새 임시 폴더에서 명령마다 한 번씩만 했습니다. 파이썬은 Homebrew로 설치된 Python 3.15.0, 시간은 time.perf_counter로 쟀고, Claude Code 2.1.309는 로그인된 상태에서 --model opus로 돌렸습니다. AI 단계를 뺀 나머지 단계는 전체 걸린 시간이 0.0초로 찍혔습니다.
호출 수와 계산 수는 이번 코드에서 센 값이지만, 시간은 한 번 잰 값이라 반복하면 달라질 수 있습니다. 캐시 전후의 호출 깊이나 메모리 사용량은 재지 않았습니다. 여러분의 함수에서 캐시 효과를 확인하려면 cache_info()의 hits와 misses를 찍어 보는 것이 가장 간단합니다.
참고 자료
- sys — 시스템 특정 파라미터와 함수 docs.python.org
- functools — 고차 함수와 콜러블 객체에 대한 연산 docs.python.org