삽입 정렬 원리, 파이썬 구현부터 내장 정렬 비교까지
삽입 정렬을 파이썬으로 직접 돌려 보니 1000개 입력에서 정렬된 입력은 비교 999번, 거꾸로 된 입력은 499,500번이었습니다. 개수에 따른 시간 배율, 내장 정렬과의 차이, AI에게 맡긴 내림차순 코드까지 확인합니다.
Finn ·
값 1000개를 삽입 정렬로 정렬할 때, 이미 정렬된 입력은 비교 999번으로 끝났습니다. 그런데 같은 값을 거꾸로 넣자 비교가 499,500번까지 늘었죠. 이 글은 삽입 정렬의 원리와 함께, 입력 모양에 따라 성능을 어떻게 판단할지, AI가 짠 정렬 코드를 어떻게 검증할지를 파이썬 코드로 확인합니다. 결론부터 말하면 제품 코드에는 내장 sorted()를 기본으로 쓰는 편이 좋습니다. AI 코딩 도구가 짜 준 정렬 코드를 검증해야 하는 1인 개발자라면 그대로 따라 해 볼 수 있습니다.
삽입 정렬은 무엇이고, 결과는 어땠을까요?
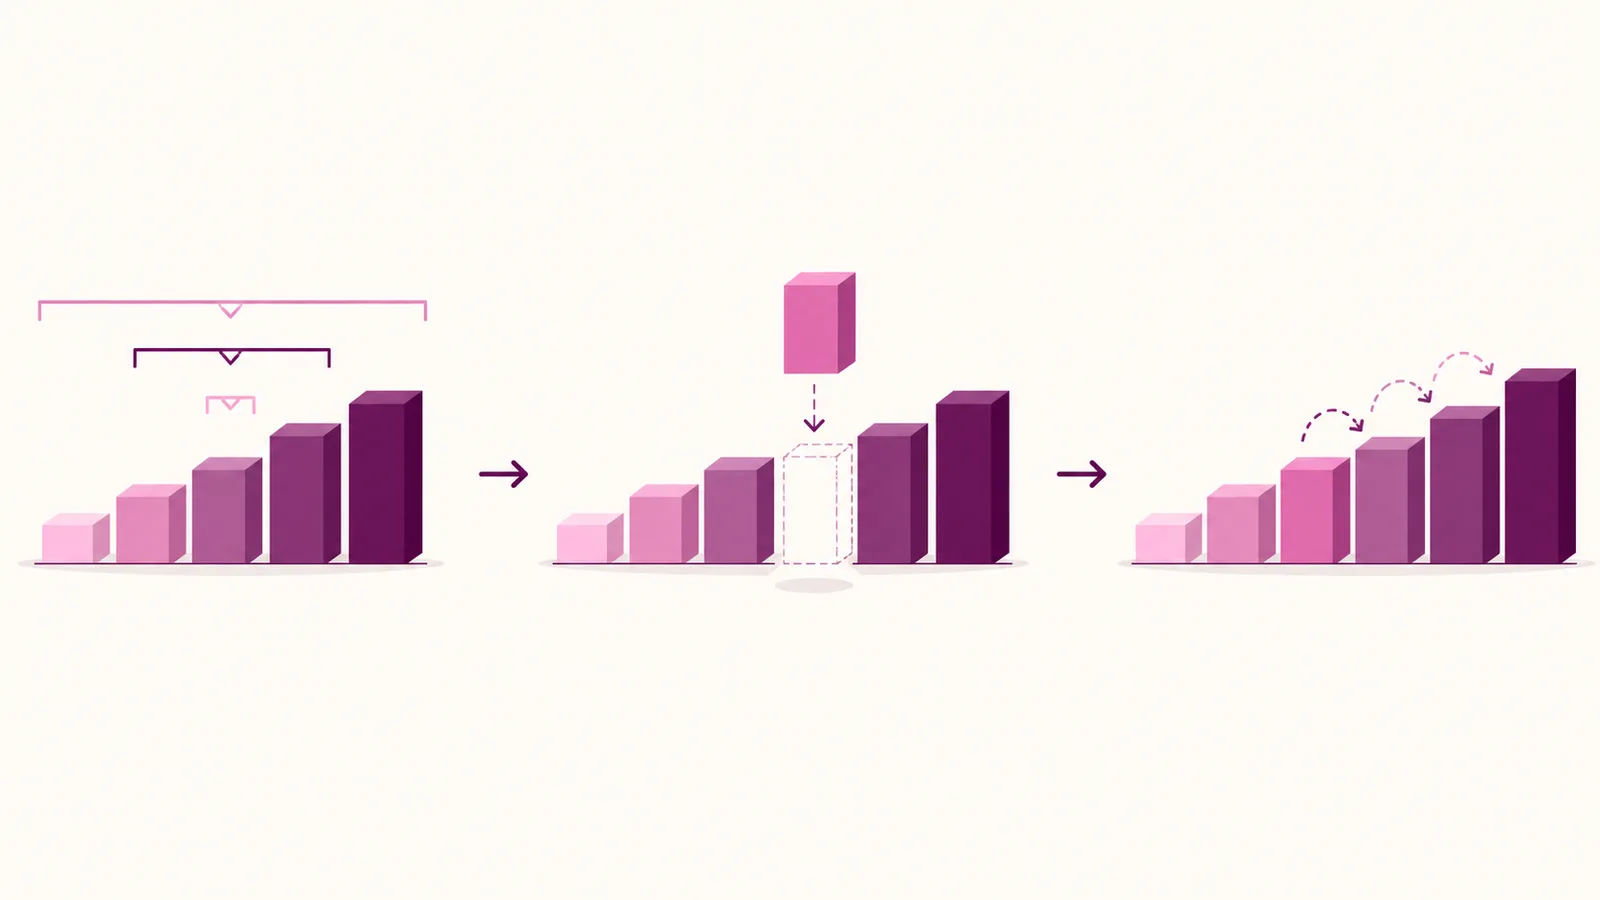
삽입 정렬은 리스트의 앞쪽을 늘 정렬된 상태로 두고, 그다음 값을 하나씩 꺼내 앞쪽의 알맞은 자리에 끼워 넣는 정렬입니다. 새 값보다 큰 값은 한 칸씩 뒤로 밀고, 빈 자리에 새 값을 넣는 식이죠.
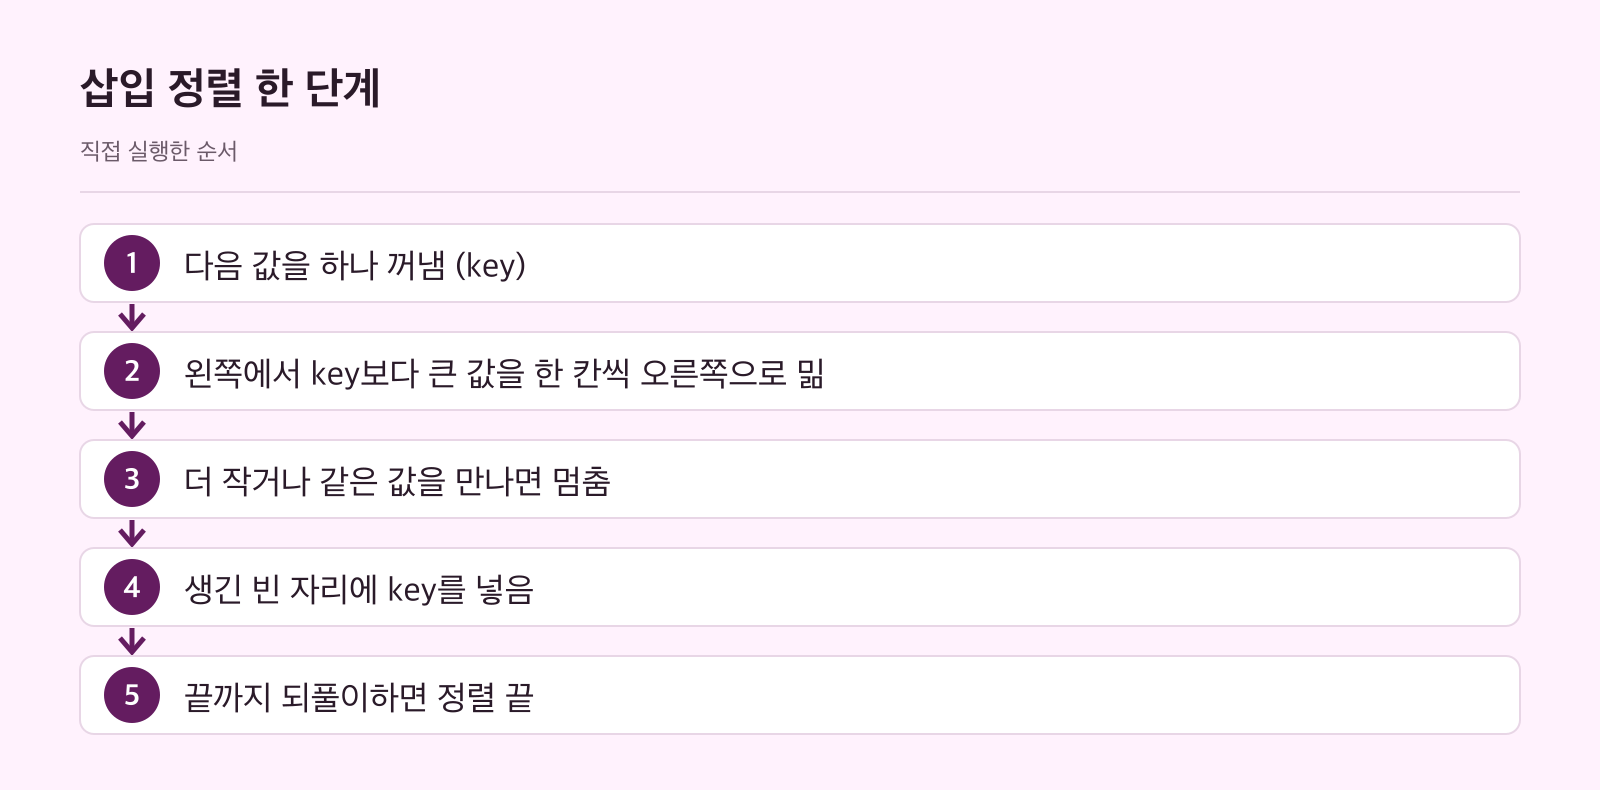
정리하면 삽입 정렬은 이미 정렬된 입력에서는 금방 끝나지만, 거꾸로 되거나 무작위인 입력에서는 개수의 제곱에 가깝게 늘어납니다. 같은 8000개에서는 sorted()보다 약 667배 느렸으니, 제품 코드에는 내장 정렬을 쓰고 삽입 정렬은 원리를 익히거나 AI가 짠 정렬 코드를 검증할 때 쓰는 편이 좋습니다.
| 구분 | 내용 |
|---|---|
| 장점 | 거의 정렬된 입력에 강함 (1000개에서 비교 1,008번) |
| 장점 | 같은 값의 원래 순서를 유지함 |
| 단점 | 무작위 입력에서는 개수의 제곱에 가깝게 느려짐 |
이번에 실행한 코드에서 나온 핵심 측정값은 세 가지입니다.
- 이미 정렬된 입력: 비교가 n-1번(1000개에서 999번)이었고 이동은 0번이었습니다.
- 거꾸로 된 입력: 비교가 n(n-1)/2번(1000개에서 499,500번)으로 늘었습니다.
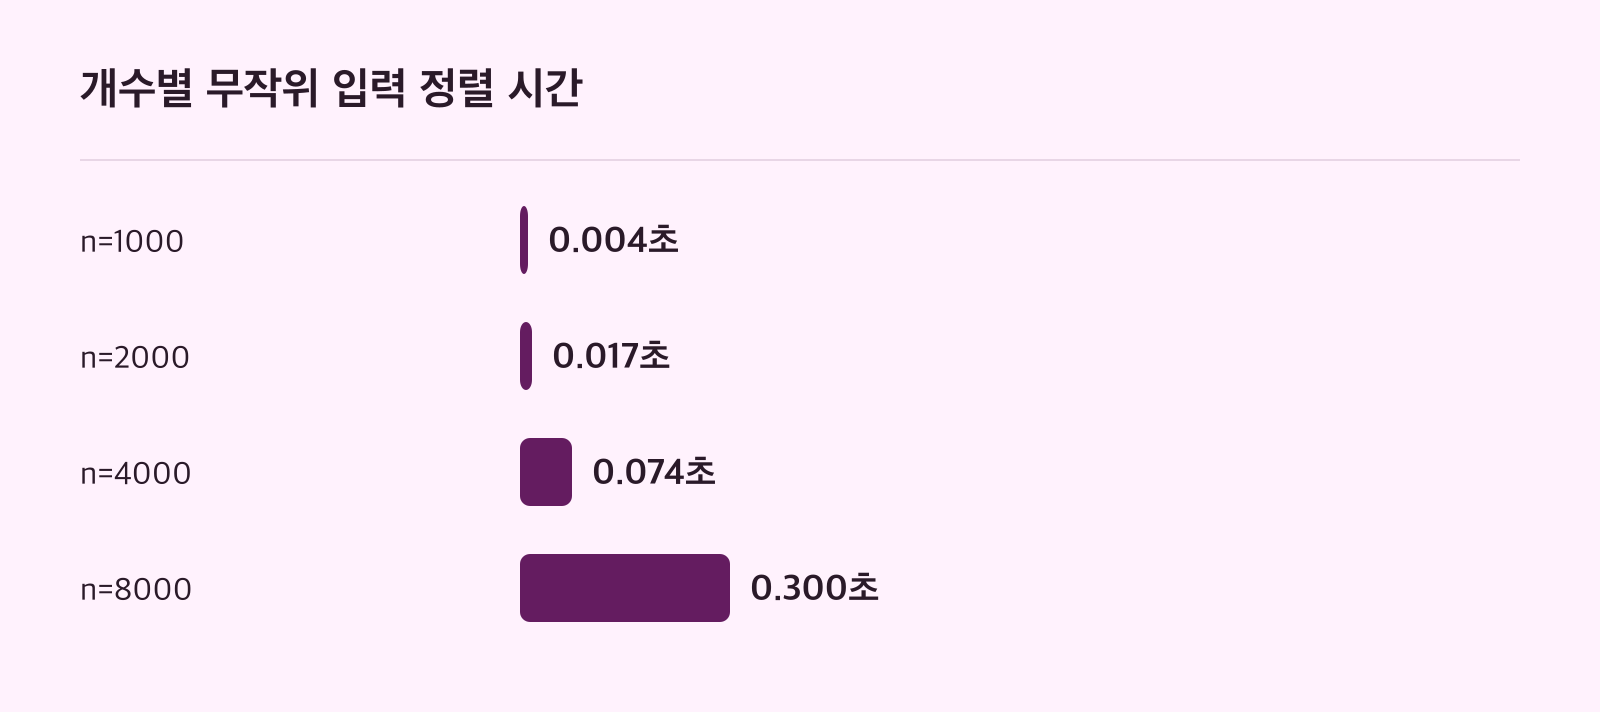
- 무작위 입력: 개수를 두 배로 늘릴 때마다 시간이 4.4배, 4.5배, 4.0배 늘었습니다.
비교 횟수는 입력이 정해지면 언제 실행해도 같은 값입니다. 반면 시간은 이 맥(darwin arm64, Python 3.15.0)에서 세 번 재서 가장 짧은 값이라, 다른 컴퓨터에서는 달라집니다. 이제 배열이 실제로 어떻게 바뀌는지부터 보겠습니다.
함께 읽을 글
배열이 단계마다 어떻게 바뀔까요?
[5, 2, 4, 6, 1, 3]을 넣고, 값 하나를 끼워 넣을 때마다 배열을 찍어 보면 과정이 바로 보입니다.
$ python3 - <<'PY'
def insertion_sort(a):
    a = list(a)
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key
        print(f"{i}단계: {key} 넣음 → {a}")
    return a
print("결과:", insertion_sort([5, 2, 4, 6, 1, 3]))
PY
1단계: 2 넣음 → [2, 5, 4, 6, 1, 3]
2단계: 4 넣음 → [2, 4, 5, 6, 1, 3]
3단계: 6 넣음 → [2, 4, 5, 6, 1, 3]
4단계: 1 넣음 → [1, 2, 4, 5, 6, 3]
5단계: 3 넣음 → [1, 2, 3, 4, 5, 6]
결과: [1, 2, 3, 4, 5, 6]
3단계를 눈여겨보세요. 6은 앞쪽의 어떤 값보다 크니 배열이 그대로입니다. 반대로 4단계의 1은 가장 작아서 앞의 값 네 개를 모두 밀어내고 맨 앞에 들어갔어요. 이 차이가 곧 입력 모양에 따른 비교 횟수 차이로 이어집니다.
입력 모양에 따라 비교 횟수는 얼마나 다를까요?
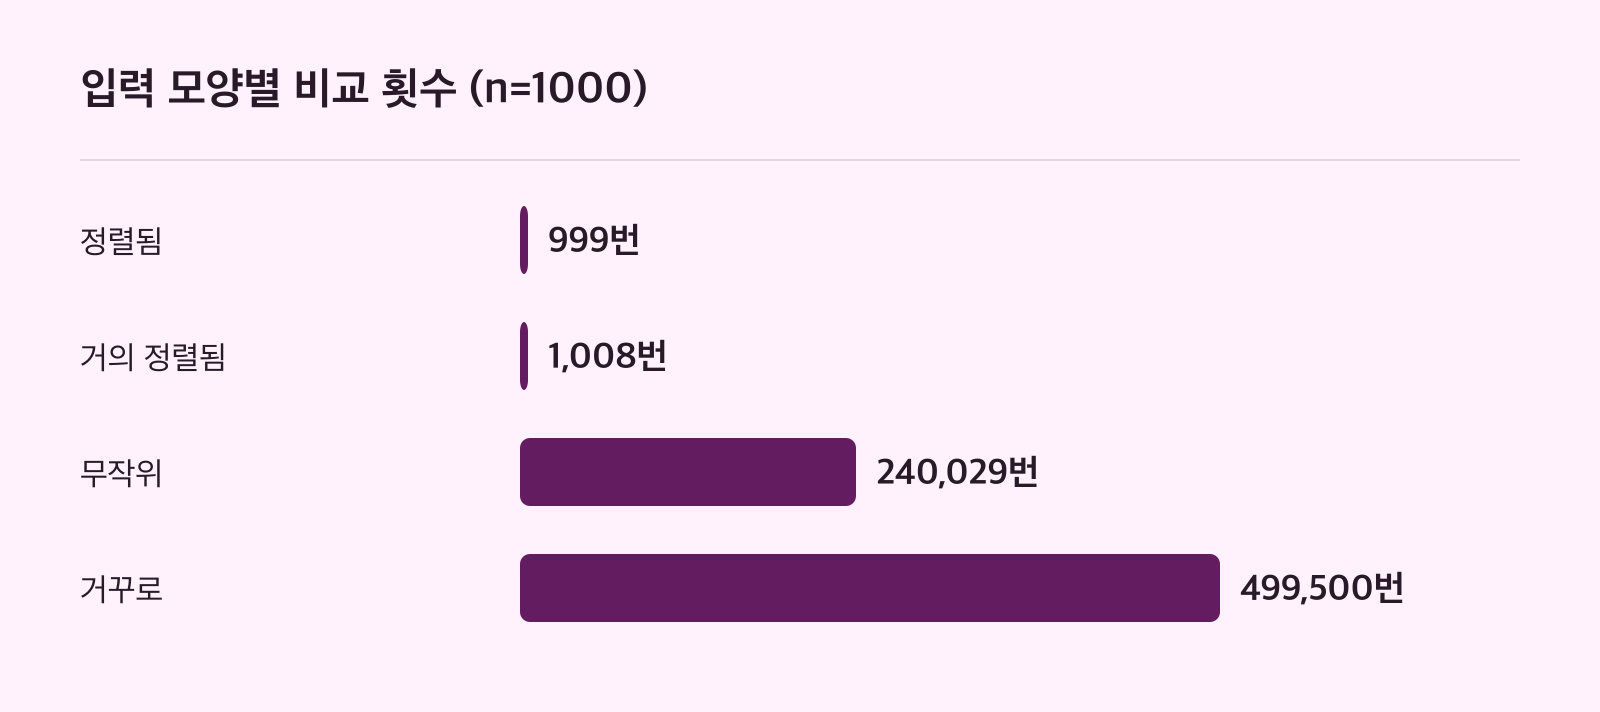
같은 무작위 값 1000개(random.seed(1))를 정렬됨, 무작위, 거꾸로, 거의 정렬됨 네 모양으로 바꿔 비교와 이동을 셌습니다. 거의 정렬됨은 정렬된 리스트에서 100칸마다 이웃한 두 값을 맞바꾼 입력입니다.
$ python3 - <<'PY'
import random
def count(a):
    a = list(a); comps = moves = 0
    for i in range(1, len(a)):
        key = a[i]; j = i - 1
        while j >= 0:
            comps += 1
            if a[j] > key:
                a[j + 1] = a[j]; j -= 1; moves += 1
            else:
                break
        a[j + 1] = key
    return comps, moves
n = 1000
random.seed(1)
rnd = [random.random() for _ in range(n)]
nearly = sorted(rnd)
for k in range(0, n, 100):
    nearly[k], nearly[k + 1] = nearly[k + 1], nearly[k]
cases = {"정렬됨": sorted(rnd), "무작위": rnd, "거꾸로": sorted(rnd, reverse=True), "거의 정렬됨": nearly}
for name, data in cases.items():
    c, m = count(data)
    print(f"{name:6} n={n}: 비교 {c:,}번, 이동 {m:,}번")
print("n-1 =", n - 1, "/ n(n-1)/2 =", f"{n * (n - 1) // 2:,}")
PY| 입력 모양 (n=1000) | 비교 | 이동 |
|---|---|---|
| 정렬됨 | 999번 | 0번 |
| 거의 정렬됨 | 1,008번 | 10번 |
| 무작위 | 240,029번 | 239,034번 |
| 거꾸로 | 499,500번 | 499,500번 |
표에서 눈여겨볼 곳은 거의 정렬된 입력입니다. 몇 군데만 순서가 어긋난 목록은 정렬된 입력과 비교 횟수가 큰 차이가 없었으니, 삽입 정렬을 쓸지 판단할 때는 개수보다 입력이 어떤 모양인지부터 확인하는 편이 좋습니다.
개수를 두 배로 늘리면 시간은 얼마나 늘까요?
그렇다면 실제 시간은 어떨까요? 개수를 1000, 2000, 4000, 8000으로 늘리며 무작위 입력과 이미 정렬된 입력을 각각 쟀습니다. 무작위 데이터는 random.seed를 개수와 같은 값으로 고정했습니다.
$ python3 - <<'PY'
import random, time
def insertion_sort(a):
    a = list(a)
    for i in range(1, len(a)):
        key = a[i]; j = i - 1
        while j >= 0 and a[j] > key:
            a[j + 1] = a[j]; j -= 1
        a[j + 1] = key
    return a
def best(f, data, runs=3):
    times = []
    for _ in range(runs):
        t = time.perf_counter(); f(data); times.append(time.perf_counter() - t)
    return min(times)
prev = None
for n in (1000, 2000, 4000, 8000):
    random.seed(n)
    data = [random.random() for _ in range(n)]
    t1 = best(insertion_sort, data)
    t2 = best(insertion_sort, sorted(data))
    ratio = f", 앞의 {n // 2}개보다 {t1 / prev:.1f}배" if prev else ""
    print(f"n={n}: 무작위 {t1:.3f}초{ratio}, 이미 정렬됨 {t2:.4f}초")
    prev = t1
PY
n=1000: 무작위 0.004초, 이미 정렬됨 0.0000초
n=2000: 무작위 0.017초, 앞의 1000개보다 4.4배, 이미 정렬됨 0.0001초
n=4000: 무작위 0.074초, 앞의 2000개보다 4.5배, 이미 정렬됨 0.0001초
n=8000: 무작위 0.300초, 앞의 4000개보다 4.0배, 이미 정렬됨 0.0002초
무작위 입력은 0.004초에서 0.300초까지 늘었고, 두 배씩 늘릴 때의 배율은 4.4배, 4.5배, 4.0배였습니다. 이미 정렬된 입력은 8000개에서도 0.0002초에 머물렀어요. 이 값은 이 맥에서 세 번 잰 가장 짧은 시간이니, 직접 실행하면 숫자는 달라질 수 있습니다.
같은 값의 순서는 유지될까요?
점수가 같은 학생이 여럿일 때, 정렬 뒤에도 원래 순서가 남는지 확인해 봤습니다. 점수(두 번째 값)를 기준으로 정렬하는 코드입니다.
$ python3 - <<'PY'
def insertion_sort(a, key):
    a = list(a)
    for i in range(1, len(a)):
        item = a[i]; j = i - 1
        while j >= 0 and key(a[j]) > key(item):
            a[j + 1] = a[j]; j -= 1
        a[j + 1] = item
    return a
scores = [("민수", 80), ("지은", 90), ("하나", 80), ("도윤", 70), ("서연", 90)]
print(insertion_sort(scores, key=lambda s: s[1]))
PY
[('도윤', 70), ('민수', 80), ('하나', 80), ('지은', 90), ('서연', 90)]
80점인 민수가 하나보다, 90점인 지은이 서연보다 앞에 그대로 남았습니다. 이 코드는 앞의 값이 더 클 때만(>) 밀어내기 때문에 같은 값 앞에서 멈추죠. 그래서 비교를 >=로 바꾸는 식으로 손대면 이 출력이 달라질 수 있으니, AI가 고친 코드라면 이 예제로 다시 돌려 보는 게 좋습니다. 참고로 파이썬 정렬 기법 문서는 내장 정렬이 안정적임을 보장한다고 적고 있습니다.
파이썬 내장 정렬과 비교하면 얼마나 차이 날까요?
직접 짠 삽입 정렬을 실제 제품에 써도 될까요? 같은 8000개(seed 8000)를 삽입 정렬과 sorted()로 각각 정렬했습니다.
$ python3 - <<'PY'
import random, time
def insertion_sort(a):
    a = list(a)
    for i in range(1, len(a)):
        key = a[i]; j = i - 1
        while j >= 0 and a[j] > key:
            a[j + 1] = a[j]; j -= 1
        a[j + 1] = key
    return a
def best(f, data, runs=3):
    times = []
    for _ in range(runs):
        t = time.perf_counter(); r = f(data); times.append(time.perf_counter() - t)
    return min(times), r
random.seed(8000)
data = [random.random() for _ in range(8000)]
t1, r1 = best(insertion_sort, data)
t2, r2 = best(sorted, data)
print(f"같은 8000개(seed 8000): 삽입 정렬 {t1:.3f}초, sorted() {t2:.4f}초, 약 {t1 / t2:.0f}배 차이, 결과 같음: {r1 == r2}")
PY
같은 8000개(seed 8000): 삽입 정렬 0.306초, sorted() 0.0005초, 약 667배 차이, 결과 같음: True
결과는 같았지만 시간은 삽입 정렬 0.306초, sorted() 0.0005초로 약 667배 차이가 났습니다. 앞 절의 8000개 무작위 측정(0.300초)과 숫자가 조금 다른데, 이 측정만으로는 그 원인을 가를 수 없습니다. 궁금하다면 같은 스크립트를 여러 번 돌려 값이 얼마나 흔들리는지 확인해 보세요.
공식 문서에 따르면 파이썬이 쓰는 Timsort는 데이터에 이미 있는 순서를 활용할 수 있습니다. 이번 결과로 보면, 제품 코드에서는 내장 정렬을 쓰고 삽입 정렬은 원리 학습이나 AI가 쓴 코드 검증용으로 두는 편이 합리적인 판단입니다.
이진 탐색으로 자리를 찾는 변형은?
삽입할 자리를 앞에서부터 하나씩 비교하지 않고 이진 탐색으로 찾는 방법도 있습니다. 표준 라이브러리 bisect.insort가 그 역할을 해요.
$ python3 - <<'PY'
import bisect, random
random.seed(1)
data = [random.random() for _ in range(1000)]
result = []
for x in data:
    bisect.insort(result, x)
print("정렬됨:", result == sorted(data), "/ 개수:", len(result))
PY
정렬됨: True / 개수: 1000
1000개를 하나씩 넣은 결과는 sorted()와 같았습니다. 다만 이 단계에서는 시간을 따로 재지 않았으니, 삽입 정렬보다 빠르다고 단정할 수는 없습니다. bisect 문서는 insort()가 자리를 찾는 로그 시간 탐색보다 선형 시간 삽입 단계에 지배되므로 O(n)이라고 설명합니다.
Claude Code에게 내림차순을 맡기면?
이번엔 AI 코딩 도구에 맡겨 봤습니다. Claude Code 2.1.309에 --model opus로 내림차순 삽입 정렬을 요청하고, 받은 코드를 그대로 실행했습니다.
$ claude --model opus -p "파이썬으로 리스트를 내림차순으로 정렬하는 삽입 정렬 함수 insertion_sort_desc를 쓰고, 그 아래에 print(insertion_sort_desc([3, 8, 1, 9, 4]))를 넣은 코드만 출력해. sorted()나 sort()는 쓰지 말고, 설명이나 코드 블록 표시는 붙이지 마." > desc.py && cat desc.py && python3 desc.py
def insertion_sort_desc(arr):
    arr = arr[:]
    for i in range(1, len(arr)):
        key = arr[i]
        j = i - 1
        while j >= 0 and arr[j] < key:
            arr[j + 1] = arr[j]
            j -= 1
        arr[j + 1] = key
    return arr


print(insertion_sort_desc([3, 8, 1, 9, 4]))
[9, 8, 4, 3, 1]
받은 코드는 오름차순 버전에서 비교만 <로 바꾼 모양이고, 출력은 [9, 8, 4, 3, 1]이었습니다. 요청부터 받은 답을 실행해 확인하기까지 이 단계 전체에 6.6초가 걸렸어요. 이렇게 받은 정렬 코드는 앞의 비교 횟수 스크립트나 같은 값 예제에 끼워 다시 돌려 보면 쉽게 검증할 수 있습니다.
측정 조건과 한계
모든 단계는 새 임시 폴더에서 한 번씩 실행했고, 종료 코드는 모두 0이었습니다. 파이썬 버전은 다음과 같습니다.
$ python3 --version
Python 3.15.0| 항목 | 내용 |
|---|---|
| 환경 | darwin arm64, Homebrew로 설치된 python3 |
| 무작위 입력 | 비교 횟수는 seed 1, 개수별 시간은 seed를 개수와 같게 고정 |
| 시간 | time.perf_counter로 세 번 재서 가장 짧은 값 |
| AI 도구 | Claude Code 2.1.309, 로그인된 상태, 모델 opus |
비교·이동 횟수는 입력이 같으면 어디서나 같은 값이 나옵니다. 하지만 시간과 배율은 이번에 실행한 이 코드, 이 맥에서의 값입니다.
참고 자료
- 정렬 기법 docs.python.org
- bisect — 배열 이진 분할 알고리즘 docs.python.org