클로드(Claude) AI 사용법, 모델 고르기와 요청 쓰는 법
클로드 AI 사용법을 회의록 작업으로 직접 측정했습니다. 요약, 할 일, 표, 제목을 한 번에 부탁하자 네 모델 모두 3번 다 형식을 지켰고, Haiku 5.5가 16.4초, 0.0056달러로 가장 빠르고 쌌습니다. 클로드에 요청 쓰는 법과 모델 고르는 기준을 정리했습니다.
Finn ·
회의록 하나를 주고 세 줄 요약, 담당자가 붙은 할 일 JSON, 결정 사항 표, 30자 이내 제목을 한꺼번에 부탁했습니다. Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 네 모델 모두 3번 중 3번 형식 검사를 통과했어요. 차이는 속도와 비용에서 났는데, 클로드 사용법을 찾는 1인 개발자라면 그 차이를 보고 일상 작업을 어느 클로드 모델에 맡길지 정할 수 있습니다. Haiku 5.5는 중앙값 16.4초, 비용 표시 0.0056달러로 가장 빠르고 가장 쌌습니다.
클로드 사용법 핵심: 형식을 적고 모델을 고르기
공식 문서는 원하는 출력 형식과 제약을 구체적으로 적고, 단계의 순서나 빠짐없음이 중요하면 번호 목록으로 지시하라고 권합니다. 이 측정의 요청도 네 가지 일을 1)~4) 번호로 나누고 파일 이름, 키 이름, 표 머리글, 글자 수를 적었습니다. 형식이 정해진 일상 작업이라면 이렇게 요청을 먼저 다듬은 뒤, 개요 문서의 설명처럼 지연 시간과 비용은 다른 모델을 골라 줄일 수 있는지부터 확인하는 편이 좋습니다.
함께 읽을 글
네 모델 결과는 어땠을까요?
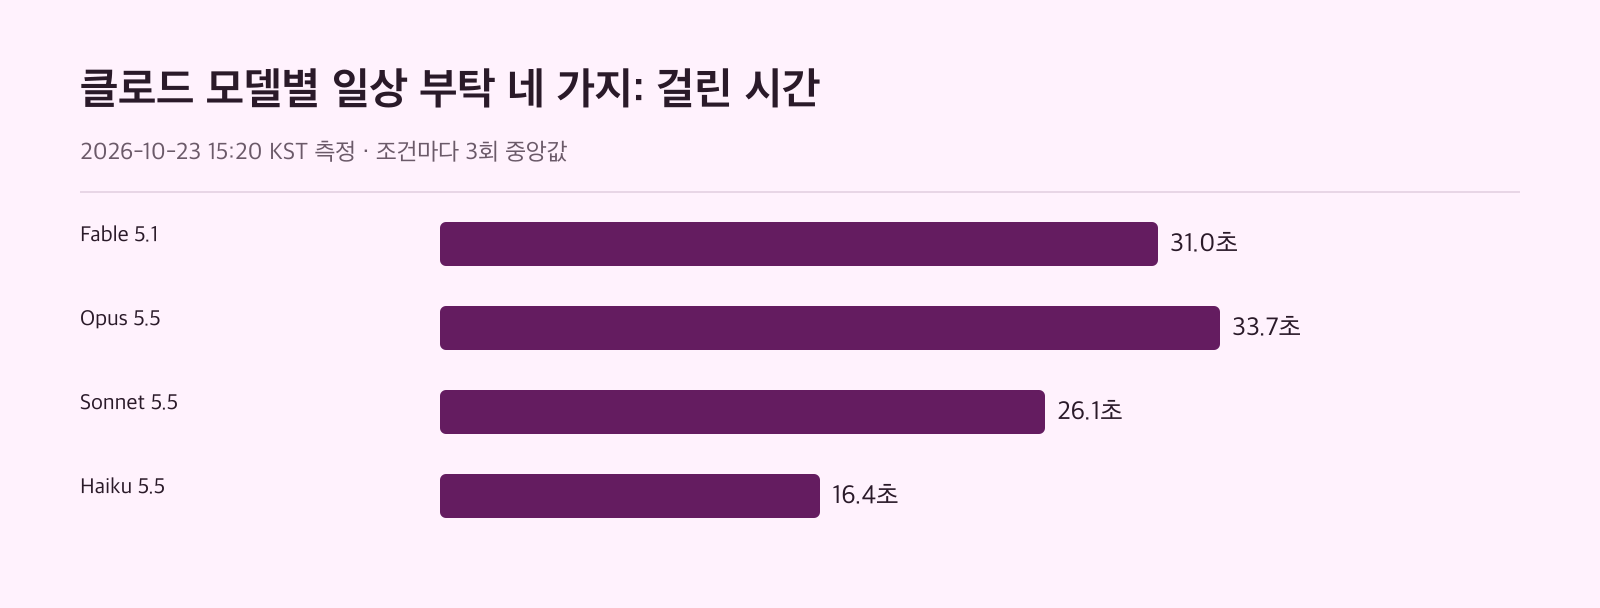
결론부터 보면, 이 정도 일상 작업에서는 네 모델 모두 형식을 지켰습니다. 형식 통과에는 차이가 없었으니, 남은 차이는 걸린 시간과 비용 표시였어요(내용 품질은 재지 않았습니다). 아래 값은 모델마다 3번씩 실행해 얻은 중앙값입니다.
| 모델 | 형식 검사 | 걸린 시간 | 입력 토큰 | 출력 토큰 | 추론 토큰 | 비용 표시(USD) |
|---|---|---|---|---|---|---|
| Fable 5.1 | 3/3 | 31.0초 | 207,685 | 2,067 | 112 | 0.41 |
| Opus 5.5 | 3/3 | 33.7초 | 162,770 | 2,418 | 11 | 0.16 |
| Sonnet 5.5 | 3/3 | 26.1초 | 195,695 | 2,039 | 0 | 0.080 |
| Haiku 5.5 | 3/3 | 16.4초 | 235,322 | 1,948 | 401 | 0.0056 |
시간은 Haiku 5.5가 16.4초로 가장 짧았고, Opus 5.5가 33.7초로 가장 길었습니다. 측정값으로 계산한 비율로 보면 Haiku 5.5의 걸린 시간은 Fable 5.1의 0.5배, Sonnet 5.5는 0.8배였죠.
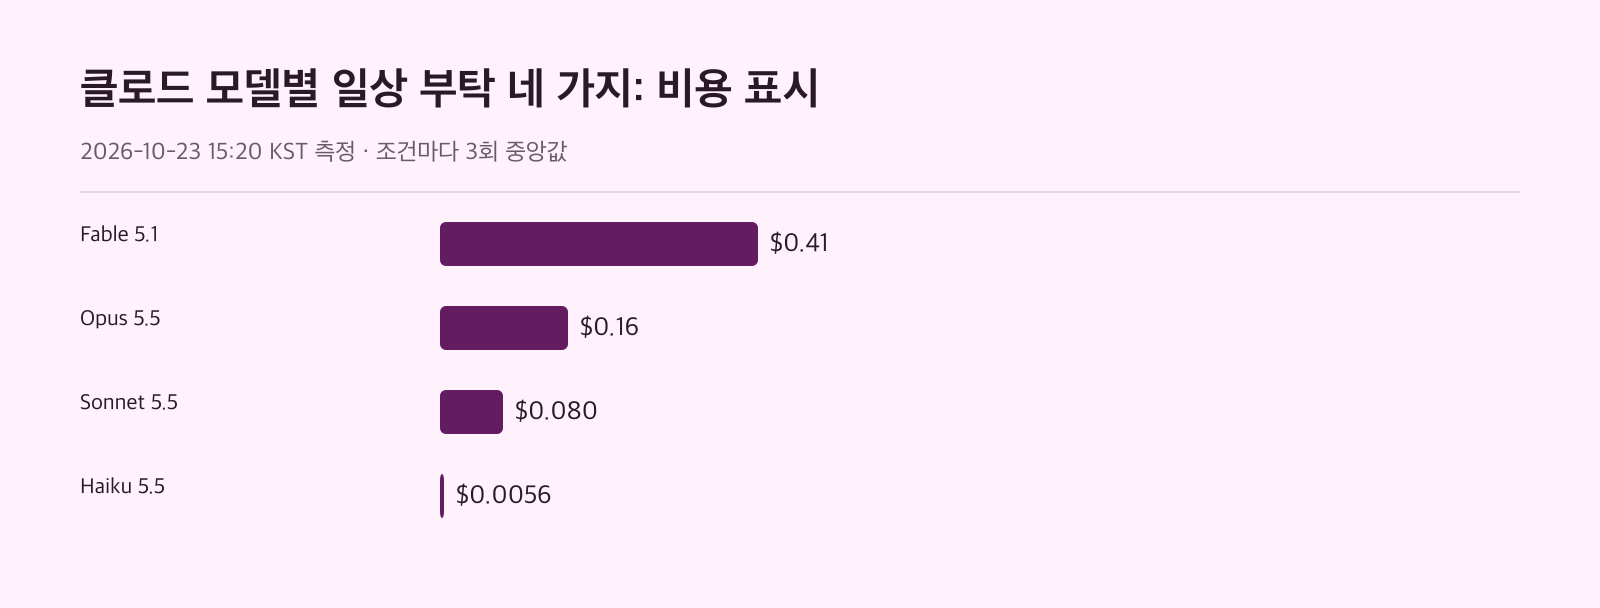
비용 표시는 차이가 더 큽니다. Fable 5.1이 0.41달러, Opus 5.5가 0.16달러, Sonnet 5.5가 0.080달러였고 Haiku 5.5는 0.0056달러였어요. 같은 형식 검사를 통과한 실행에서도 비용 표시가 이만큼 벌어졌습니다. 다만 내용 정확성은 재지 않았으니, 반복 작업에 쓸 모델은 결과물 내용까지 직접 확인한 뒤 고르는 편이 좋습니다.
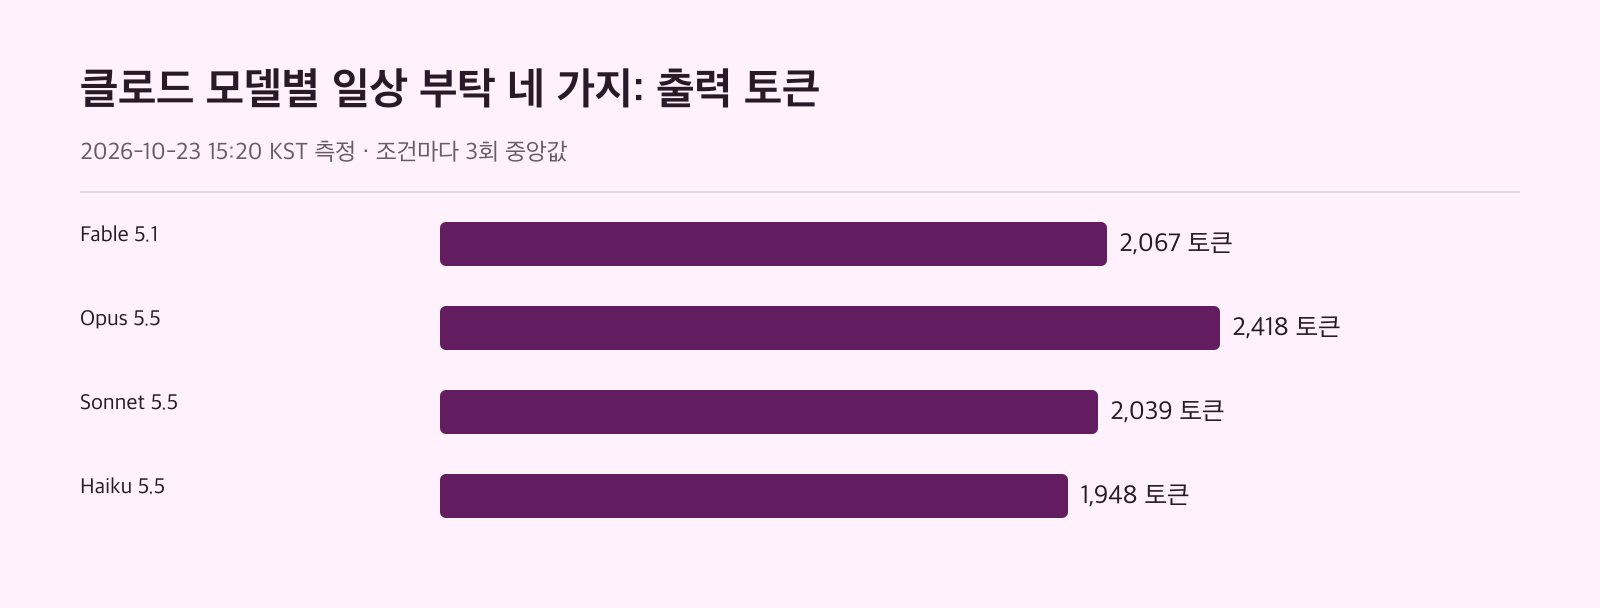
그런데 토큰은 어떨까요? 출력 토큰은 1,948에서 2,418 사이로 비슷했습니다. 입력 토큰은 Haiku 5.5가 235,322로 가장 많았는데도 비용 표시는 가장 낮았어요. 이 측정만으로는 원인을 가를 수 없습니다. 궁금하다면 결과 JSON의 usage 항목에서 새 입력, 캐시 쓰기, 캐시 읽기를 나눠 보세요.
그대로 복사해 쓰는 요청 문장
모든 모델에 아래 요청을 똑같이 보냈습니다. 그대로 복사해 파일 이름만 바꿔 써도 됩니다.
in/meeting.md는 회의록입니다. 다음 네 가지를 해 주세요. 1) 회의 내용을 정확히 세 줄로 요약해 out/summary.md에 저장. 2) 할 일을 JSON 배열로 out/todos.json에 저장(각 항목은 task, owner 두 키, owner는 회의록의 이름 그대로). 3) 정한 것을 머리글이 항목 | 결정인 마크다운 표로 out/decisions.md에 저장. 4) 회의에 30자 이내 제목을 붙여 out/title.txt에 한 줄로 저장. 다 만든 뒤 node --test로 확인해 주세요.부탁마다 형식과 저장 위치, 그리고 검사가 확인하는 조건을 맞춰 두었습니다. 요청 문장과 테스트가 어떻게 짝을 이루는지는 아래 표에 정리했어요.
| 요청 문구 | 테스트가 확인하는 것 |
|---|---|
| 정확히 세 줄로 요약 | 요약이 정확히 세 줄인지 |
| task, owner 두 키, owner는 이름 그대로 | 항목이 세 개이고 owner가 민지·준호·서연 중 하나인지 |
| 머리글이 항목 | 결정인 표 | 머리글이 정규식에 맞는지, 표 본문이 두 줄 이상인지 |
| 30자 이내 제목을 한 줄로 | 줄 수가 1이고 글자 수가 30 이하인지 |
테스트는 요청 조건 가운데 일부만 확인합니다. 키가 정확히 두 개인지, task 내용이 맞는지, 제목이 회의 내용에 맞는지는 검사하지 않습니다.
형식을 정해 준 부분은 어디일까요?
공식 프롬프트 문서는 분명하고 직접적인 지시를 권합니다. 원하는 출력 형식과 제약을 구체적으로 적으라는 거죠. 이 요청에서는 다음 부분이 그 원칙에 해당합니다.
- 형식과 제약: "정확히 세 줄", "task, owner 두 키", "머리글이 항목 | 결정", "30자 이내", "한 줄로"
- 순서 있는 단계: 문서는 순서나 빠짐없는 수행이 중요할 때 번호 목록으로 주라고 합니다. 요청의 1)~4)가 그 역할을 합니다.
- 모호함 없애기: "owner는 회의록의 이름 그대로"처럼 모델이 짐작할 여지를 줄였습니다.
마지막 문장 "node --test로 확인해 주세요"도 의미가 있습니다. 프롬프트 엔지니어링 개요는 성공 기준을 분명히 정하고 그 기준으로 시험해 볼 방법을 먼저 갖추라고 말하는데, 테스트 파일이 바로 그 기준입니다. 예를 들어 제목 검사는 이렇게 생겼어요.
test('제목은 한 줄이고 30자 이내다', () => {
  const t = lines(read('out/title.txt'));
  assert.equal(t.length, 1);
  assert.ok([...t[0]].length <= 30, `${[...t[0]].length}자`);
});
클로드 AI 사용법, 일상 작업은 어떤 모델에 맡길까요?
회의록 정리처럼 형식이 정해진 일상 작업이라면, 이 측정에서는 Haiku 5.5나 Sonnet 5.5부터 써 보는 쪽이 합리적인 판단으로 보입니다. 네 모델이 모두 검사를 통과했고, 그중 두 모델의 시간과 비용 표시가 가장 낮았기 때문이에요. 공식 개요 문서도 지연 시간과 비용은 다른 모델을 고르는 것으로 더 쉽게 개선되기도 한다고 적고 있습니다.
그렇다면 Fable 5.1이나 Opus 5.5는 언제 쓸까요? 이 측정은 형식만 검사했기 때문에 그 질문에는 답하지 못합니다. 대신 이런 순서를 권합니다.
- 요청에 형식과 제약을 번호 목록으로 적습니다.
- 결과를 확인할 검사(테스트, 체크리스트)를 함께 만듭니다.
- 가장 저렴한 모델로 몇 번 돌려 보고, 검사를 통과하지 못할 때 더 큰 모델로 바꿉니다.
참고로 문서에 따르면 Fable 5.1은 에이전트 작업 중 도구 호출 사이에 사용자에게 보여 주는 진행 안내를 덜 쓰는 편입니다. 진행 상황을 보고 싶다면 요청에 그 내용을 따로 적어 두세요.
회차마다 얼마나 흔들렸나요?
중앙값만 보면 놓치는 부분이 있습니다. Sonnet 5.5는 회차별로 44.2초, 21.8초, 26.1초가 걸렸고, Fable 5.1의 입력 토큰은 175,956에서 314,393까지 달랐습니다. 반면 형식 검사는 네 모델 모두 회차마다 빠짐없이 통과했습니다. 그래서 한 번 재 본 시간으로 모델을 판단하기보다는, 직접 실행해 보면서 몇 번 반복해 보는 쪽이 안전합니다. 회차별 기록에는 권한 거부 항목도 있습니다. 이 측정에서는 명령을 node --test만 허용했는데, 대부분의 회차에서 권한 거부가 1건씩 기록됐고 그 회차들도 모두 형식 검사를 통과했습니다. 무엇을 시도하다 거부됐는지는 이 기록만으로는 알 수 없으니, 실행 기록을 열어 직접 확인해 보는 편이 좋습니다. claude -p로 반복 작업을 자동화한다면 파일 수정은 --permission-mode acceptEdits로 허용하고, 실행할 수 있는 명령은 검사에 필요한 것만 남겨 두었는지부터 점검해 보세요. 비용도 반복 횟수까지 따져 봐야 합니다. 하루에 여러 번 돌리는 작업이라면 회당 0.0056달러(Haiku 5.5)와 0.41달러(Fable 5.1)의 차이가 횟수만큼 쌓이니, 싼 모델이 형식 검사와 내용 확인을 통과하는지 먼저 보고 필요할 때만 올리는 편이 좋습니다.
측정 조건과 한계
- 도구: Claude Code 2.1.309, darwin arm64, Node.js v22.23.1. claude.ai 화면에서는 재지 않았습니다.
- 실행: 조건마다 작업 폴더를 새 임시 폴더로 복사해
claude -p로 비대화형 실행했고, 3번씩 번갈아 돌려 중앙값을 썼습니다. - 격리: 사용자 설정·스킬·플러그인·훅·MCP 서버를 불러오지 않았습니다(
--setting-sources project,--strict-mcp-config). 파일 수정은--permission-mode acceptEdits로 허용했고, 명령은node --test만 허용했습니다. - 성공 기준:
node --test가 통과하고 테스트 파일과 회의록이 바뀌지 않았을 때만 셌습니다. 요약 내용이 정확한지는 검사하지 않았고, 형식만 확인했습니다. - 모델 외 조건: 네 모델 모두 같은 요청 문장과 기본 추론 강도로 실행했습니다.
- 비용: 결과 JSON의
total_cost_usd값을 그대로 옮긴 비용 표시입니다.
참고 자료
- Prompting best practices platform.claude.com
- Prompt engineering overview platform.claude.com