ai 프롬프트 작성법, 클로드 코드와 코덱스에 3번씩 맡겨 보니
회의록 한 편을 ai 프롬프트 두 가지로 클로드 코드와 코덱스에 3번씩 맡겼습니다. 파일 이름만 적으면 0/3, 줄 수·JSON 키·표 머리글·글자 수까지 적으면 3/3이 통과했습니다. 시간·토큰 차이와 공식 가이드의 작성 원칙을 함께 다룹니다.
Finn ·
같은 회의록을 두고 두 가지 ai 프롬프트를 Claude Code(Opus 5.5)와 Codex(GPT-6.1 Sol)에 3번씩 맡겼습니다. 하나는 저장할 파일 이름만 적었고, 다른 하나는 줄 수·JSON 키·표 머리글·글자 수까지 적었죠. 짧은 프롬프트는 두 도구 모두 0/3, 자세한 프롬프트는 두 도구 모두 3/3으로 테스트를 통과했습니다. 걸린 시간 중앙값은 클로드 코드가 29.7초에서 26.2초로, 코덱스가 26.3초에서 21.4초로 줄었습니다.
형식을 적으면 결과가 얼마나 달라지나요?
이 작업에서는 형식을 적었는지가 성공과 실패를 그대로 갈랐습니다. 도구를 바꿔도 같았어요. 짧은 프롬프트는 두 도구 모두 세 번 다 실패했고, 자세한 프롬프트는 두 도구 모두 세 번 다 성공했습니다.
| 조건 | 테스트 통과 | 걸린 시간 | 입력 토큰 | 출력 토큰 | 도구 호출 |
|---|---|---|---|---|---|
| 클로드 코드·짧은 프롬프트 | 0/3 | 29.7초 | 161,754 | 2,388 | 7 |
| 클로드 코드·자세한 프롬프트 | 3/3 | 26.2초 | 161,741 | 2,627 | 7 |
| 코덱스·짧은 프롬프트 | 0/3 | 26.3초 | 73,552 | 986 | 6 |
| 코덱스·자세한 프롬프트 | 3/3 | 21.4초 | 43,645 | 761 | 3 |
표의 값은 모두 3회 중앙값입니다. 성공은 실행이 끝난 뒤 그 폴더에서 node --test가 통과하고, 테스트 파일이 바뀌지 않았을 때만 셌습니다. 클로드 코드의 비용 표시는 두 조건 모두 0.16 USD였습니다.
테스트가 확인한 것은 네 가지입니다.
- 요약(
out/summary.md)이 정확히 세 줄인지 - 할 일(
out/todos.json)이task·owner를 가진 세 항목의 JSON 배열이고, 담당자가 민지·준호·서연인지 - 결정 사항(
out/decisions.md)이항목 | 결정머리글을 가진 표이고, 본문이 두 줄 이상인지 - 제목(
out/title.txt)이 한 줄이고 30자 이내인지
그렇다면 짧은 프롬프트는 어느 검사에서 떨어졌을까요? 회차별로 어떤 검사가 실패했는지는 측정 기록에 남아 있지 않습니다. 직접 따라 해 본다면 실패한 폴더에서 node --test를 다시 돌려 어떤 항목이 빨간색인지 확인해 보세요.
함께 읽을 글
측정에 쓴 두 프롬프트는 무엇인가요?
두 도구에 보낸 문장은 똑같습니다. 먼저 짧은 프롬프트입니다.
in/meeting.md는 회의록입니다. 이 회의록으로 요약, 할 일 목록, 결정 사항, 제목을 만들어 out 폴더에 summary.md, todos.json, decisions.md, title.txt로 저장해 주세요.자세한 프롬프트는 같은 일을 번호 목록으로 나누고, 파일마다 형식을 적었습니다.
in/meeting.md는 회의록입니다. 다음 네 가지를 해 주세요. 1) 회의 내용을 정확히 세 줄로 요약해 out/summary.md에 저장. 2) 할 일을 JSON 배열로 out/todos.json에 저장(각 항목은 task, owner 두 키, owner는 회의록의 이름 그대로). 3) 정한 것을 머리글이 항목 | 결정인 마크다운 표로 out/decisions.md에 저장. 4) 회의에 30자 이내 제목을 붙여 out/title.txt에 한 줄로 저장.두 프롬프트를 테스트 항목과 나란히 놓으면 차이가 분명합니다. 짧은 프롬프트에는 테스트가 확인하는 형식이 하나도 적혀 있지 않죠. 테스트 파일은 실행하는 동안 작업 폴더에서 빼 두었기 때문에, 모델은 프롬프트에 적힌 것만 보고 결과를 만들어야 했습니다.
형식을 길게 적으면 더 느려지지 않을까요?
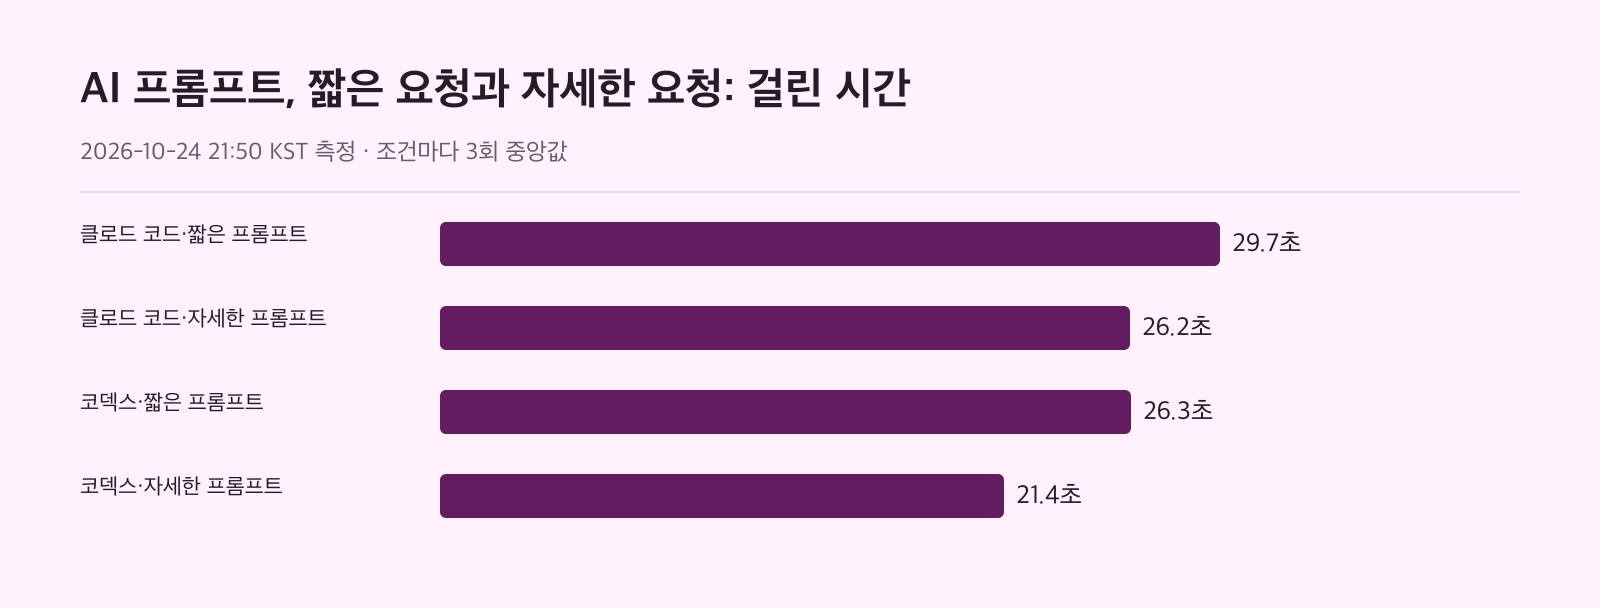
이 측정에서는 오히려 반대였습니다. 걸린 시간 중앙값은 클로드 코드가 29.7초에서 26.2초, 코덱스가 26.3초에서 21.4초였습니다. 다만 회차마다 편차가 컸다는 점은 알아 두세요. 클로드 코드·짧은 프롬프트는 22.8초부터 33.0초까지, 코덱스·짧은 프롬프트는 16.3초부터 30.8초까지 퍼져 있었습니다.
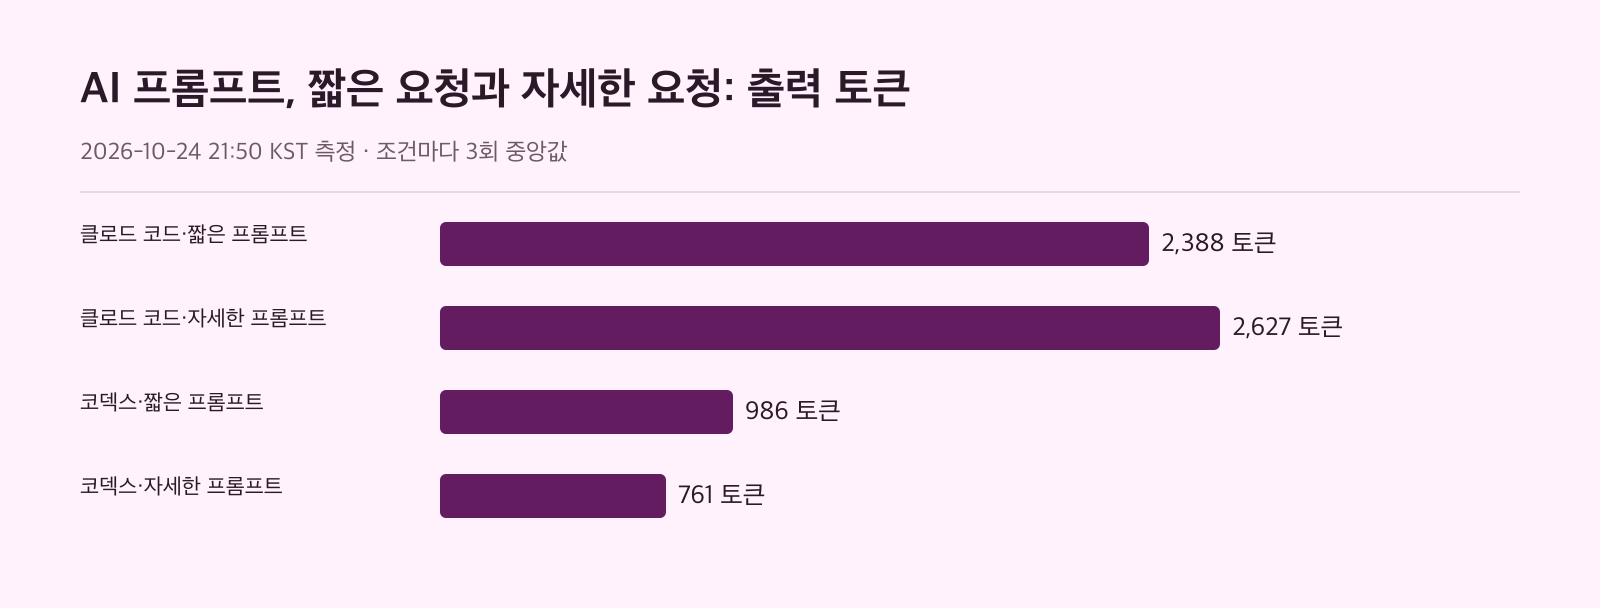
출력 토큰은 두 도구가 다르게 움직였습니다. 클로드 코드는 2,388에서 2,627로 늘었고(1.1배), 코덱스는 986에서 761로 줄었습니다. 추론 토큰은 클로드 코드가 91에서 172였고, 코덱스는 두 조건 모두 0이었습니다.
입력 토큰에서는 코덱스의 차이가 컸습니다. 코덱스·자세한 프롬프트는 43,645로, 클로드 코드·짧은 프롬프트의 0.3배였죠. 클로드 코드는 161,754와 161,741로 두 조건이 거의 같았습니다.
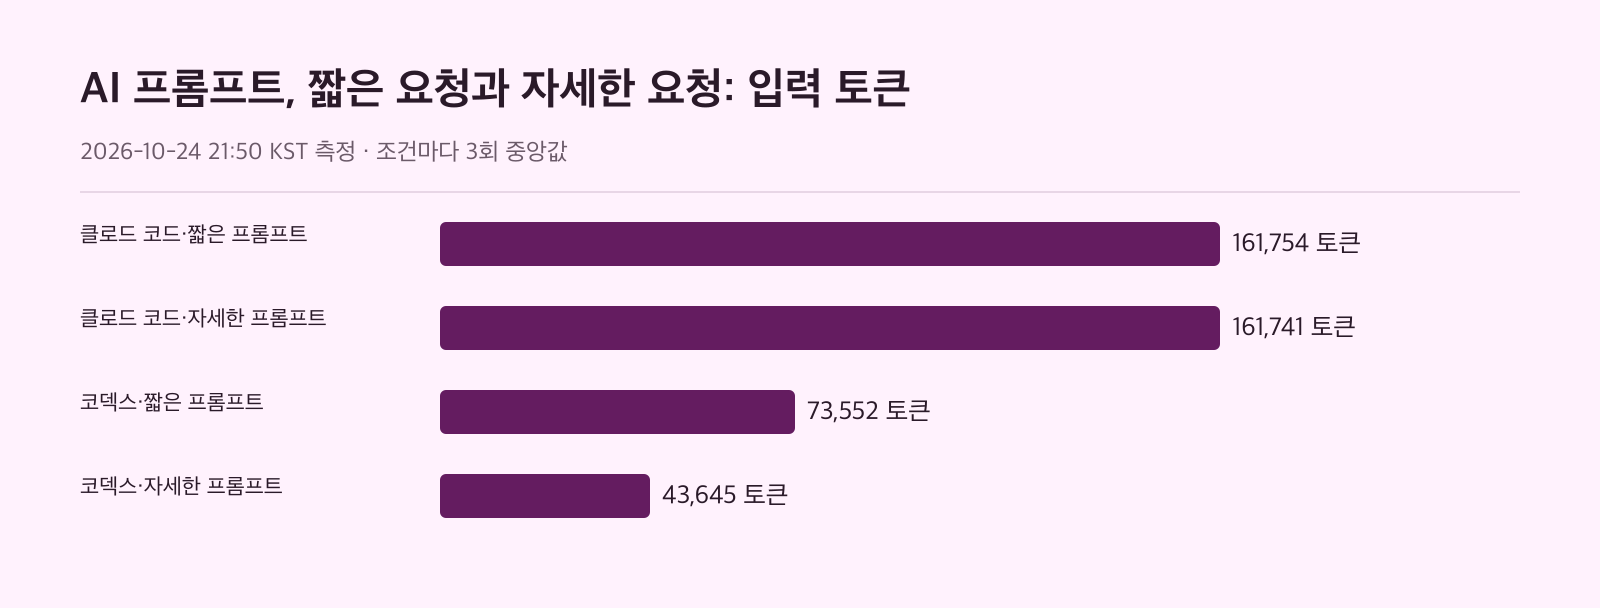
그런데 코덱스·자세한 프롬프트는 도구 호출도 6번에서 3번으로 함께 줄었습니다. 입력 토큰이 줄어든 것이 이것 때문인지는 이 측정만으로는 가를 수 없습니다. 시간이 줄어든 이유도 마찬가지입니다. 내 작업에서 확인하고 싶다면 실행 기록 JSON의 usage 값과 도구 호출 수를 회차별로 나란히 놓고 비교해 보세요.
공식 가이드는 프롬프트 작성법을 어떻게 설명하나요?
측정 결과는 두 회사의 공식 가이드와 같은 방향을 가리킵니다. Anthropic의 Prompting best practices에서 짚는 점은 이렇습니다.
- 분명하고 직접적으로 씁니다. 원하는 출력 형식과 제약을 구체적으로 적으라고 합니다.
- 단계의 순서나 빠짐없음이 중요하면 번호 목록이나 글머리표로 나눠 적습니다.
- 맥락을 모르는 똑똑한 신입 직원에게 설명하듯 씁니다. 맥락이 거의 없는 동료가 읽고 헷갈린다면 Claude도 헷갈린다는 점검법을 제시합니다.
- 예시는 형식·말투·구조를 잡는 가장 믿을 만한 방법 가운데 하나로, 3~5개를
<example>태그로 감싸라고 권합니다. - 지시·맥락·예시·입력이 섞이면
<instructions>,<context>,<input>같은 XML 태그로 나눕니다. - JSON처럼 정해진 구조가 필요하면 먼저 그 구조를 따르라고 요청해 보고, 스키마로 응답을 묶는 structured outputs 기능도 쓸 수 있습니다.
OpenAI의 Prompt engineering 가이드도 비슷합니다. 마크다운 머리글·목록과 XML 태그로 프롬프트의 경계를 나누라고 하죠. 또 developer 메시지를 정체성, 지시, 예시, 맥락 순서로 구성하는 틀을 제시합니다. 모델 출력은 비결정적이라서 프롬프트 동작을 측정하는 테스트와 평가 묶음을 만들라고도 강하게 권합니다.
이번 자세한 프롬프트는 이 가운데 번호 목록과 구체적인 형식만 썼고, 예시나 XML 태그는 넣지 않았습니다. 그래서 예시를 꼭 넣어야 하냐고 물으신다면, 이 측정으로는 답할 수 없습니다. 형식만 적어도 이 작업은 3/3이었다는 데까지가 확인한 내용입니다.
프롬프트 ai에 형식을 적는 순서
AI 코딩 도구에 파일을 만들게 할 때 측정과 가이드에서 끌어낸 순서입니다.
- 결과물을 번호로 나눕니다. 파일 하나에 한 번호를 주면 빠지는 항목이 없는지 한눈에 보입니다.
- 형식을 검사할 수 있는 말로 적습니다. "정확히 세 줄", "task, owner 두 키", "머리글이 항목 | 결정인 표", "30자 이내 한 줄"처럼 숫자와 이름으로 씁니다.
- 값을 어디서 가져올지 못박습니다. 측정 프롬프트의 "owner는 회의록의 이름 그대로"처럼, 테스트가 정확한 값을 확인한다면 그 출처를 적어 둡니다.
- 형식이 까다로우면 예시를 붙입니다. Anthropic 가이드는 3~5개를 태그로 감싸라고 합니다.
- 입력과 지시가 섞이면 구조로 나눕니다. XML 태그나 마크다운 머리글로 경계를 표시합니다.
- 형식은 테스트로 확인합니다. 측정에 쓴 제목 검사는 이렇게 생겼습니다.
test('제목은 한 줄이고 30자 이내다', () => {
  const t = lines(read('out/title.txt'));
  assert.equal(t.length, 1);
  assert.ok([...t[0]].length <= 30, `${[...t[0]].length}자`);
});
혼자 제품을 만들고 있다면 이 테스트를 프롬프트와 같은 폴더에 두는 것을 권합니다. 그러면 프롬프트를 고칠 때마다 node --test 한 번으로 형식이 깨졌는지 확인할 수 있죠.
자주 하는 실수도 짚어 볼게요.
- 파일 이름만 적고 형식은 모델이 알아서 맞추리라 기대하기(이번 측정의 짧은 프롬프트가 0/3이었던 조건입니다)
- "짧게", "깔끔하게"처럼 검사할 수 없는 말로 형식을 대신하기
- 하지 말 것만 적기(Anthropic 가이드는 하지 말 것 대신 해야 할 것을 적으라고 합니다)
보내기 전 점검 목록입니다.
- 결과 파일마다 번호가 있는가
- 줄 수·키 이름·머리글·글자 수가 숫자와 이름으로 적혀 있는가
- 맥락 없는 동료가 읽어도 같은 결과를 만들 수 있는가
- 형식을 확인하는 테스트가 있는가
측정 조건과 한계
측정은 2026-10-24에 darwin arm64, Node.js v22.23.1 환경에서 Claude Code 2.1.309와 codex-cli 0.163.0-alpha.11.2로 했습니다.
- 조건마다 작업 폴더를 새 임시 폴더로 복사하고, 비대화형으로 3번씩 번갈아 실행해 중앙값을 썼습니다.
- 네 조건 모두 같은 회의록과 기본 추론 강도로 실행했고, 프롬프트와 도구만 바꿨습니다.
- 테스트 파일은 실행하는 동안 작업 폴더에서 빼 두었다가, 끝난 뒤 다시 넣고 검사했습니다.
- 클로드 코드는
claude -p로, 사용자 설정·스킬·플러그인·훅·MCP 서버 없이 실행했습니다. 파일 수정은 자동 허용, 명령은node --test만 허용했습니다. - 코덱스는
codex exec --json으로, 사용자 설정·규칙 파일·플러그인·앱 연결·사용자 스킬을 끄고 작업 폴더에만 쓸 수 있는 샌드박스(-s workspace-write)에서 실행했습니다.
한계도 분명합니다. 작업은 회의록 정리 하나뿐이라 다른 작업이나 다른 모델에서는 결과가 다를 수 있습니다. 조건마다 3번씩이라 0/3과 3/3은 거친 성공률로 읽어야 하고, 시간과 토큰은 회차마다 편차가 컸습니다. 내 제품에 적용하기 전에는 OpenAI 가이드가 권하듯 내 작업으로 테스트를 만들어 직접 돌려 보세요.
참고 자료
- Prompting best practices platform.claude.com
- Prompt engineering developers.openai.com