클로드 코드(Claude Code) 세션 압축, 초기화와 비교해 고르는 기준
클로드 코드 세션 압축을 직접 실행해 보면 긴 파일을 읽힌 첫 요청 입력은 238497토큰이었고, 압축한 뒤에는 32073토큰으로 물어도 파일 줄 수를 기억했습니다. 컨텍스트가 찰 때 압축과 초기화 중 무엇을 고를지 기준과 따라 할 명령을 담았습니다.
Finn · · 수정
클로드 코드에 긴 파일 하나를 읽힌 대화는 첫 요청에서 입력 토큰이 238497이었습니다. 같은 대화를 /compact로 압축하고 "앞에서 읽은 파일은 몇 줄이었나요?"라고 다시 묻자, 입력 32073토큰으로 정확히 3000이라고 답했죠. 반면 새 대화에서는 입력이 30745토큰이었지만 파일을 읽은 적이 없다고 답했습니다. Claude Code 컨텍스트가 찰 때 압축과 초기화 중 무엇을 고를지, 이 실행 기록과 공식 문서를 함께 보며 정리합니다.
압축하면 무엇이 줄고 무엇이 남을까요?
결론부터 말하면, 지금 하던 작업을 이어 갈 거라면 압축(/compact)을, 관계없는 작업으로 넘어갈 거라면 초기화(/clear)를 쓰면 됩니다. 아래 표는 새 폴더에서 명령을 차례대로 한 번씩 실행한 결과입니다.
| 단계 | 입력 토큰 | 출력 토큰 | 답 |
|---|---|---|---|
| 3. 파일을 읽혀 대화 시작 | 238497 | 687 | 3000(줄 수) |
| 4. 같은 대화에서 한 번 더 묻기 | 59386 | 10 | 설정 항목 3000 |
| 6. 압축 뒤 같은 대화에서 묻기 | 32073 | 4 | 3000 |
| 7. 새 대화에서 같은 질문 | 30745 | 108 | 읽은 적이 없어 모른다 |
여기서 입력 토큰은 결과 JSON에 있는 새 입력, 캐시 읽기, 캐시 쓰기를 더한 값입니다. 압축한 뒤에도 같은 대화는 파일 줄 수를 기억했지만, 새 대화는 기억하지 못했어요. 7단계는 /clear를 직접 측정한 결과가 아니라, 이전 대화를 이어받지 않은 새 호출 결과입니다. 이 측정만으로는 /clear 직후의 상태가 새 호출과 같은지 가를 수 없으니, 초기화 결과가 궁금하다면 같은 대화에서 /clear를 실행한 뒤 같은 질문을 던져 직접 확인하는 편이 좋습니다.
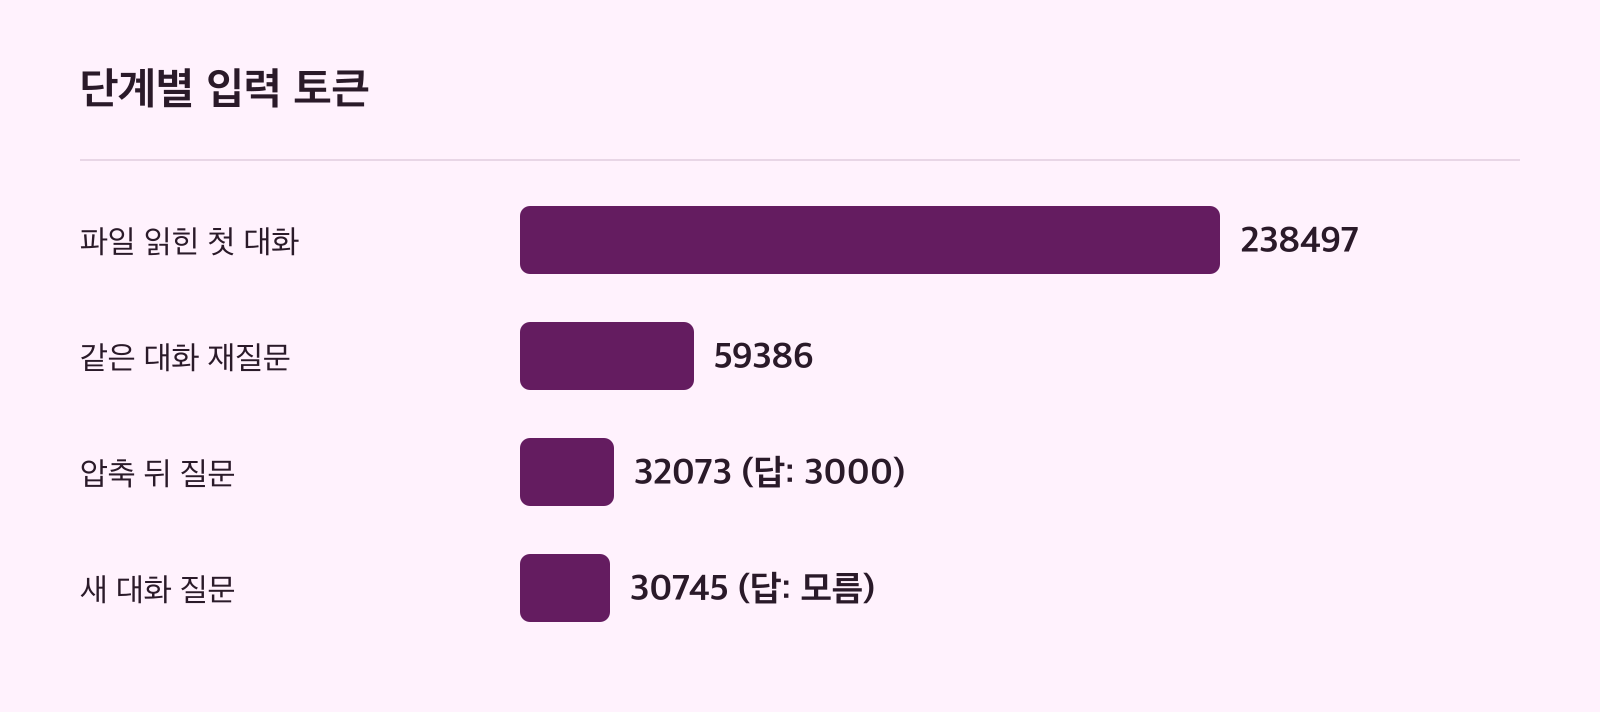
그런데 3단계와 4단계 사이에도 입력 토큰이 크게 달라졌죠. 왜일까요? 이 기록에는 단계별 합계만 남아 있어서, 이 측정만으로는 원인을 가를 수 없습니다. 직접 확인하고 싶다면 대화형 세션에서 단계마다 /context를 실행해 분류별 사용량을 비교해 보세요. 압축 뒤의 답 3000이 요약에서 나왔는지, 압축 직후 다시 읽은 파일에서 나왔는지도 이 기록만으로는 알 수 없습니다.
그렇다면 두 명령은 정확히 무엇이 다를까요?
함께 읽을 글
압축과 초기화는 무엇이 다를까요?
컨텍스트 창 문서에 따르면 /compact는 대화를 구조화된 요약으로 바꾸고, 시작할 때 불러온 내용은 대부분 자동으로 다시 들어옵니다. /clear는 관계없는 작업으로 넘어갈 때 쓰라고 안내해요. 오래된 대화가 다음에 필요한 파일의 자리를 차지하고, 메시지를 보낼 때마다 토큰이 들기 때문입니다.
비용을 볼 때도 차이가 있습니다. 비용 관리 문서에 따르면 /usage의 세션 합계는 /clear로 새 세션이 시작되면 0부터 다시 셉니다(v2.1.211 전에는 프로세스가 살아 있는 동안 계속 쌓였습니다). 또 v2.1.251 이상에서 /usage에 보이는 프롬프트 캐시 줄은 압축 때문에 생긴 캐시 미스를 '예상된 재구성(expected rebuild)'으로 따로 셉니다. 그래서 압축 직후 캐시 미스가 보여도 이상 신호로 볼 필요는 없어요.
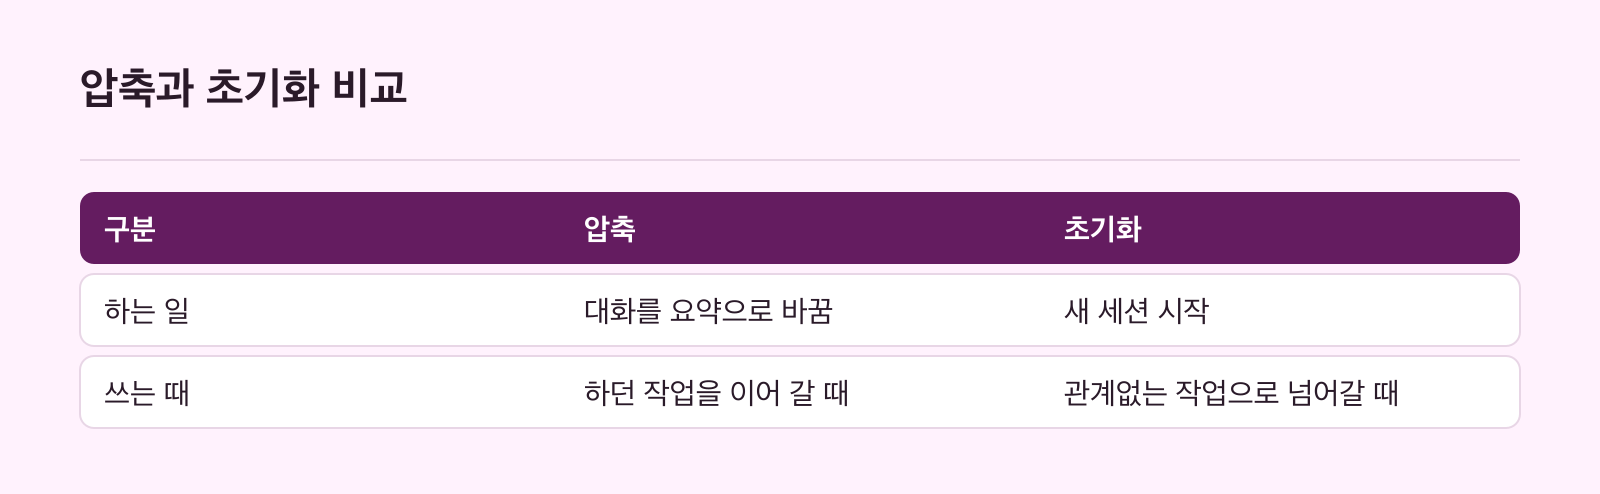
혼자 제품을 만들고 있다면 이렇게 나눠 보세요. 같은 기능을 계속 고치는 중이라면 압축으로 맥락을 이어 가고, 결제 버그를 끝내고 랜딩 페이지 작업으로 넘어가는 것처럼 주제가 바뀌면 초기화하는 식이죠.
압축 뒤에 남는 것과 사라지는 것
압축한다고 모든 내용이 같은 방식으로 요약되지는 않습니다. 문서의 표에서 혼자 작업할 때 자주 부딪히는 항목만 골라 옮기면 다음과 같습니다.
| 내용 | 압축 뒤 |
|---|---|
| 시스템 프롬프트, 출력 스타일 | 그대로 적용 |
| 프로젝트 루트 CLAUDE.md, 범위 없는 규칙 | 디스크에서 다시 넣음 |
| 자동 메모리, 플랜 모드에서 쓴 계획 | 디스크에서 다시 넣음 |
| 스킬 설명 | 현재 스킬로 다시 만들어 넣음(v2.1.304 이상) |
paths: 머리말이 있는 규칙, 하위 폴더 CLAUDE.md | 필요할 때 다시 불러옴 |
| 읽거나 고친 파일 | 최근에 수정된 순서로 최대 다섯 개를 다시 읽음 |
| 호출한 스킬 본문 | 스킬당 5,000토큰, 합계 25,000토큰까지 다시 넣고 오래된 것부터 뺌 |
| 훅이 앞서 넣은 맥락 | 나머지 대화와 함께 요약 |
여기서 주의할 점이 두 가지 있어요. 첫째, 5,000토큰이 넘는 파일은 내용 없이 경로만 돌아오고 Read 대신 Referenced file로 표시됩니다. 둘째, paths: 규칙과 하위 폴더 CLAUDE.md는 대화 기록 안에 들어가 있다가 압축할 때 다른 내용과 함께 요약됩니다. 압축 뒤에도 반드시 지켜야 하는 규칙이라면 paths: 머리말을 빼거나 프로젝트 루트 CLAUDE.md로 옮기라고 문서는 권합니다. 스킬 본문은 잘릴 때 앞부분이 남으니, 중요한 지시는 SKILL.md 위쪽에 두세요.
자동 압축과 지시를 붙여 압축하는 방법
Claude Code는 한도에 가까워지면 자동으로 압축하기 때문에, 컨텍스트가 가득 차도 세션이 끝나지는 않습니다. 자동 압축도 /compact와 같은 방식으로 동작해요. 그렇다면 굳이 직접 압축할 이유가 있을까요? 자동 압축은 무엇이 중요한지 추측하지만, 직접 압축할 때 지시를 붙이면 요약에 남길 내용을 직접 고를 수 있습니다.
- 지시를 붙여 압축: 긴 새 작업을 시작하기 전에
/compact focus on the auth bug fix처럼 실행합니다. - 대화 일부만 압축:
/rewind로 메시지를 고른 뒤 Summarize from here 또는 Summarize up to here를 고릅니다. - 더 일찍 압축:
/autocompact 500k처럼 토큰 수를 넣으면 자동 압축이 돌기 전까지 컨텍스트가 얼마나 찰지 정할 수 있습니다. - 큰 파일 읽기 맡기기: 조사를 서브에이전트에 보내면 파일 내용이 내 컨텍스트가 아니라 그쪽 컨텍스트 창에 남습니다.
자동 압축이 도는 지점은 모델과 설정에 따라 다릅니다. 또 v2.1.198부터는 요약 요청이 세션의 확장 사고(extended thinking) 설정을 그대로 따르고, 압축이 끝난 뒤 세션 설정은 바뀌지 않습니다.
직접 따라 해 보는 순서
빈 폴더에서 아래 순서대로 실행하면 같은 비교를 해 볼 수 있습니다. 출력 정리에 jq를 쓰고, --setting-sources project와 --strict-mcp-config로 사용자 설정과 MCP 서버를 불러오지 않습니다.
- 버전을 확인합니다.
claude --version- 3000줄짜리 파일을 만듭니다.
seq 1 3000 | sed 's/^/설정 항목 /' > notes.txt && wc -l < notes.txt- 파일을 읽혀 대화를 시작하고, 세션 ID를
session.txt에 저장합니다.
claude -p "notes.txt를 끝까지 읽고 줄 수만 숫자로 답해 주세요" --model claude-opus-5-5 --setting-sources project --strict-mcp-config --output-format json | tee r1.json | jq '{"답": .result, "입력_토큰": (.usage.input_tokens + .usage.cache_read_input_tokens + .usage.cache_creation_input_tokens), "출력_토큰": .usage.output_tokens}' && jq -r .session_id r1.json > session.txt- 같은 대화에서 한 번 더 묻습니다.
claude -p --resume "$(cat session.txt)" "그 파일의 마지막 줄을 그대로 적어 주세요" --model claude-opus-5-5 --setting-sources project --strict-mcp-config --output-format json | jq '{"답": .result, "입력_토큰": (.usage.input_tokens + .usage.cache_read_input_tokens + .usage.cache_creation_input_tokens), "출력_토큰": .usage.output_tokens}'- 대화를 압축합니다. 오류 값이
false면 성공입니다.
claude -p --resume "$(cat session.txt)" "/compact" --model claude-opus-5-5 --setting-sources project --strict-mcp-config --output-format json | jq '{"오류": .is_error}'- 압축 뒤 같은 대화에서 묻습니다.
claude -p --resume "$(cat session.txt)" "앞에서 읽은 파일은 몇 줄이었나요? 숫자만 답해 주세요" --model claude-opus-5-5 --setting-sources project --strict-mcp-config --output-format json | jq '{"답": .result, "입력_토큰": (.usage.input_tokens + .usage.cache_read_input_tokens + .usage.cache_creation_input_tokens), "출력_토큰": .usage.output_tokens}'- 새 대화에서 같은 질문을 합니다.
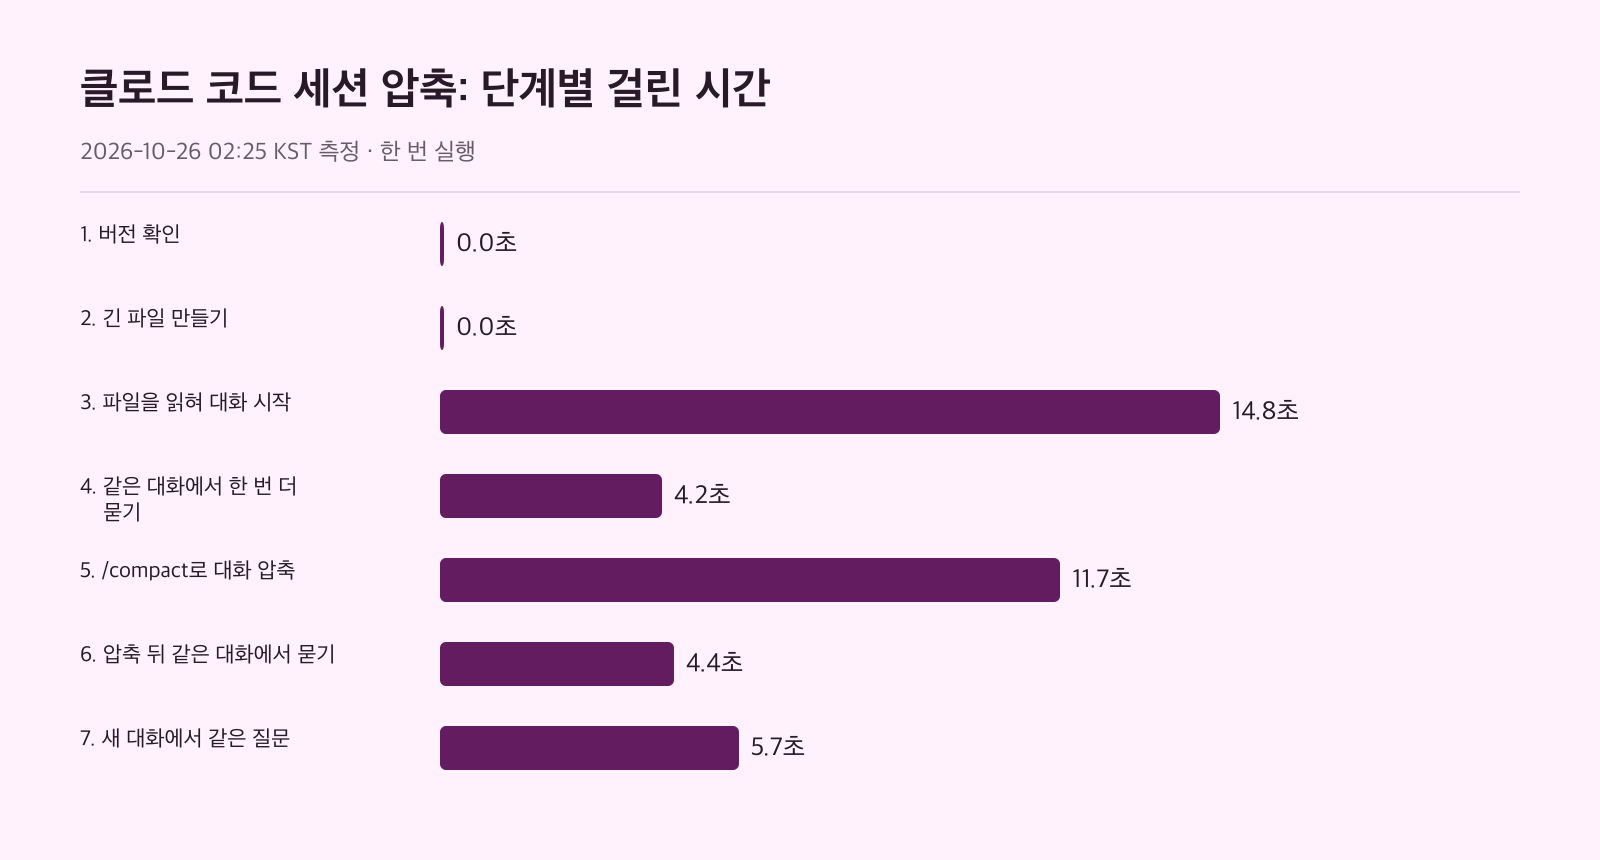
claude -p "앞에서 읽은 파일은 몇 줄이었나요? 모르면 모른다고 답해 주세요" --model claude-opus-5-5 --setting-sources project --strict-mcp-config --output-format json | jq '{"답": .result, "입력_토큰": (.usage.input_tokens + .usage.cache_read_input_tokens + .usage.cache_creation_input_tokens), "출력_토큰": .usage.output_tokens}'걸린 시간은 파일을 읽힌 첫 대화가 14.8초로 가장 길었고, 압축은 11.7초였습니다. 압축 뒤 질문은 4.4초, 새 대화 질문은 5.7초가 걸렸고 모든 단계의 종료 코드는 0이었어요.
자주 하는 실수
- 6단계와 7단계를 헷갈리기:
--resume없이 실행하면 새 대화가 되어, 7단계처럼 앞 내용을 모른다고 답합니다. - 입력 토큰을
input_tokens하나로만 보기: 이 글의 수치는 새 입력에 캐시 읽기와 캐시 쓰기까지 더한 값입니다. - 꼭 지켜야 할 규칙을
paths:규칙에만 두기: 압축할 때 대화와 함께 요약됩니다. - 큰 파일 내용이 압축 뒤에도 그대로 남을 거라 기대하기: 5,000토큰이 넘는 파일은 경로만 돌아옵니다.
- 관계없는 작업을 압축으로 이어 가기: 이럴 때 문서가 권하는 방법은
/clear입니다.
압축하기 전 점검 목록
/context로 지금 컨텍스트 사용량과 불러온 CLAUDE.md를 확인했나요?- 다음 작업이 지금 대화와 이어지나요? 이어진다면 지시를 붙여 압축하고, 그렇지 않다면 초기화하세요.
- 압축 뒤에도 지켜야 할 규칙이 프로젝트 루트 CLAUDE.md에 들어 있나요?
- 스킬의 중요한 지시가
SKILL.md위쪽에 있나요? - 큰 파일 조사는 서브에이전트에 맡겼나요?
측정 조건과 한계
맥 한 대(darwin arm64, Node.js v22.23.1)에서 Claude Code 2.1.309와 모델 claude-opus-5-5로 실행한 기록입니다. 대화형 화면이 아닌 claude -p로 실행했고, --resume으로 같은 대화를 이었으며, 사용자 설정과 MCP 서버는 불러오지 않았습니다. 단계마다 한 번씩만 실행했기 때문에 실행할 때마다 수치가 얼마나 흔들리는지는 알 수 없어요.
또 내용이 단순한 3000줄 파일 하나로만 시험했고, 한도에 가까워졌을 때 도는 자동 압축은 재지 않았습니다. 문서에 따르면 CLAUDE.md, 자동 메모리, MCP 도구 이름, 스킬 설명은 입력하기 전에 미리 컨텍스트에 들어갑니다. 그래서 평소 설정과 MCP 서버를 켠 환경이라면 숫자가 달라질 수 있으니, 자기 프로젝트에서 같은 명령을 돌려 직접 확인해 보세요.
참고 자료
- Explore the context window code.claude.com
- Manage costs effectively code.claude.com